从看清数据到因果结构
你卡在哪一步?顺着研究问题找到你的方法 ——
统计方法是一条递进的路径,不是一堆并列的工具。左侧目录按阶排列,每一阶都建立在前一阶之上——跳阶容易概念断层,建议按序往下走:
- 入门篇——先看清数据本身:描述统计看连续变量、频率分析看分类变量。
- 关系篇——两个变量什么关系:连续变量看共变(相关)、分组看均值差(组间比较)。
- 测量篇——前面用的量表分数稳不稳?信度低,地基就软。
- 桥梁篇——回归把"相关"推进到"控制其他因素后的净效应",是后面调节/中介的引擎。
- 机制篇——往因果靠拢:调节问"对谁/何时"、中介问"为什么"、交叉滞后看时间方向。
- 结构篇——系统层面:潜变量与多路径一起算(SEM)、给人分组(潜剖面)、看谁居中(网络分析)。
每个方法页内嵌一张交互图,可拖动滑块看结果实时变化。共 12 个方法,按渐进六阶排布。
1描述统计
均值、标准差、分布形态 —— 给一组数据画张"速写"
为什么需要它
做任何分析之前,先要看清数据本身。原始数字罗列在一起,仅凭观察难以把握整体特征——需要先回答三个问题:中心在哪儿、散得多开、形状是否对称。描述统计正是回答这三个问题,为数据画一张"速写"。跳过这一步直接做推断,相当于未了解全貌就下结论。
它算不上"高级方法",但通常是论文结果章的第一节,也是决定后续用参数检验还是非参数检验的依据——分布偏态较重时,t 检验的前提便难以满足。
直观理解
下图是一组数据的直方图。拖 μ 滑块移动分布的中心、拖 σ 放大或收窄散布,观察柱形、均值线和 ±1σ 带如何随之变化。σ 越大,柱形越矮宽、数据越分散;σ 越小,柱形越高窄、数据越集中。这就是"标准差"在图形上的直观呈现。
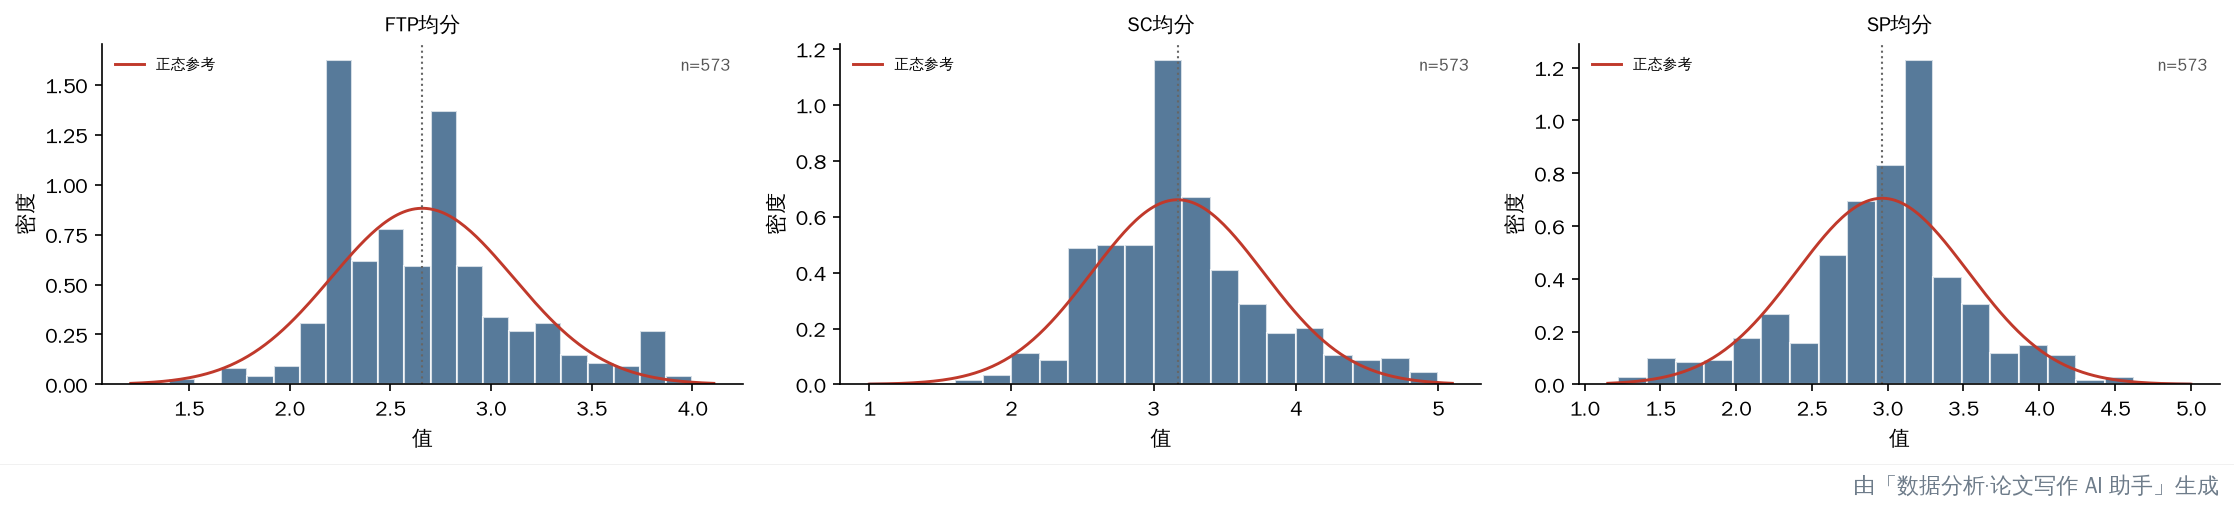
- 每个变量报 M(SD) 与 n——APA 惯例格式如 2.66(0.45),缺一不可:只报均值不报离散程度是最常见的缺漏;有明显缺失时在表注交代缺失量与处理方式。
- 偏度/峰度进表或表注——若后续用到正态性判断(t/ANOVA),方法部分写明"偏度/峰度与 Shapiro-Wilk 检验结果";偏态明显时交代"采用非参数检验"。
- 措辞规范——描述统计只做描述,不写"X 显著高于 Y"(那是推断统计的事);量表得分高低的比较留给组间比较章节。
- 直方图(descriptive_histogram.png)——蓝色直方 + 红色正态参考曲线(按该变量 M/SD 画):曲线偏离 = 偏态(左拖尾/右拖尾),峰比曲线高瘦 = 尖峰;灰色竖虚线 = 均值。这是判断"要不要用正态方法"的目测搭档(配合偏度/峰度表)。
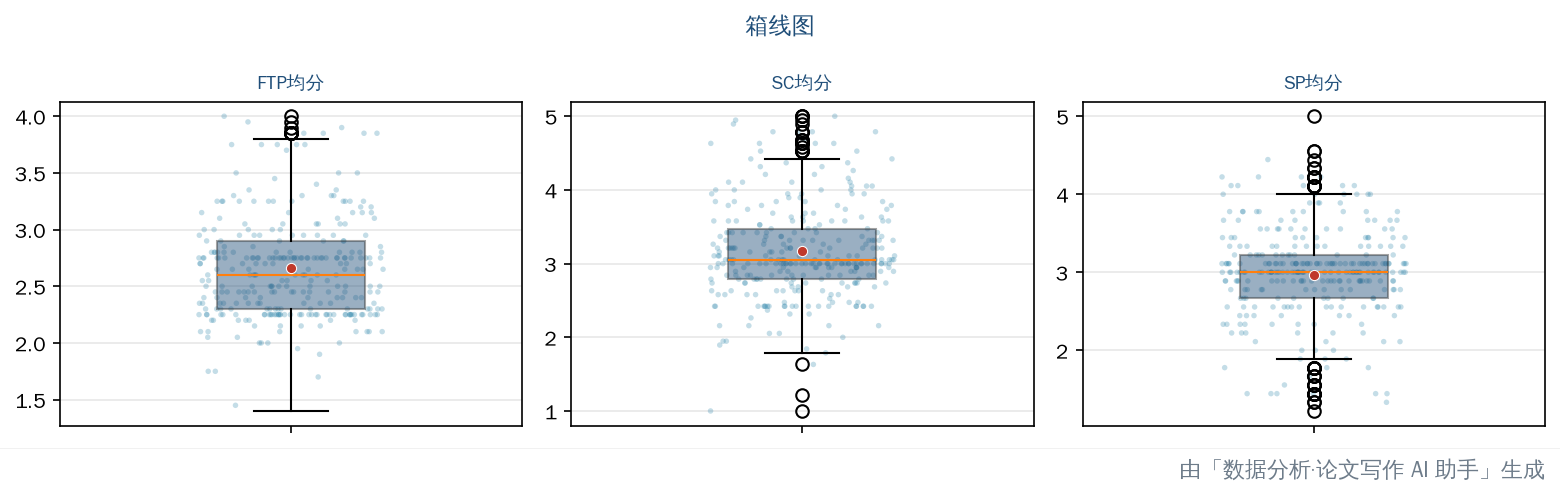
- 箱线图(descriptive_boxplot.png)——箱 = 四分位距(IQR),横线 = 中位数,须外圆圈 = 离群值;叠加浅色 jitter 散点(原始数据分布形态,>300 抽样)与红点(均值)。均值偏离中位数 = 偏态方向的旁证。
↑ 以上截图均由「数据分析·论文写作 AI 助手」对真实调查数据(护理专业学生样本,n=573)自动分析生成 · 带自己的数据去跑一遍 →
公式
均值反映中心,标准差反映离散,偏度峰度反映形状。三者合在一起才能较完整地刻画数据——只报均值不报标准差,是较为常见的报告缺漏。
前提假设
- 量纲合适:连续变量才能谈均值标准差;分类变量用频率。
- 先查异常值:一个极端值可大幅拉偏均值,但对中位数影响有限——比较两者差距有助于识别离群。
- 样本充足:样本过小,分布形态本身也不稳定。
何时用 · 何时不该用
- 用:通常先于推断。作为结果章第一节,并决定后续采用参数还是非参数检验。
- 别用:试图据此下因果结论——描述统计只说明"是什么",不回答"为什么"。
常见误区
计算原理
描述统计不"估计未知参数",而直接刻画样本本身。均值是使 Σ(残差)² 最小的中心点(数学上对 x̄ 求导得 0 的解),因而与回归共享同一套"最小二乘"逻辑。中位数则使 Σ|残差| 最小,对极值不敏感。
离散程度为何用平方而不直接用平均绝对偏差?平方使大偏差被进一步放大(极值受到更重惩罚),且平方具备可分解性——方差的可加性支撑了后续回归/ANOVA 的 SS 分解。偏度用三阶矩(立方,带符号)、峰度用四阶矩,用于刻画分布形态。
公式
数值代入 · 5 个点
数据 x = 2, 3, 4, 5, 11(n = 5,11 是极值)。下面手算 M / SD / 中位数 / 偏度。
对应滑块演示:M = 5 即 μ 滑块的位置、SD = 3.54 即 σ 滑块的取值(柱形越矮宽,σ 越大)。那个 11 把均值从 4(中位数)抬到 5、把 SD 撑大——这正是"极值拉偏均值"在数值上的体现。
2频率分析
分类变量的比例与差异 —— χ² 检验两组比例是否存在差异
为什么需要它
性别、是否、学历等级——这类分类变量不宜用均值描述,而需统计频数、计算比例。两组比例存在差异,究竟是真实差异还是抽样波动所致?卡方检验正是回答这一问题:它将"观察到的频数"与"假设两组无差异时应有的频数"加以比较,偏离较大即提示"存在差异"。
频率分析兼具分类数据的描述统计与推断统计功能:先看各组占比,再检验差异是否显著。
直观理解
下图是 2×2 列联表:实验组 vs 对照组各 n 人,"改善/未改善"堆叠成条。拖两组改善率(p̂₁、p̂₂)和每组样本量 n,看 χ²、p 和 Cramér's V 怎么变——两组比例差越大、χ² 越大;但 χ² 同时受 n 影响:同样的 10% 改善差,n=30 未必显著、n=400 即可"显著",而 V 几乎不变。这也是为何不能只看 p。
- 卡方检验三件套一个不能少:χ²(自由度)、p、效应量 Cramér's V——只报"χ²=12.4, p<.05"不给效应量,审稿人会问"差异多大"。
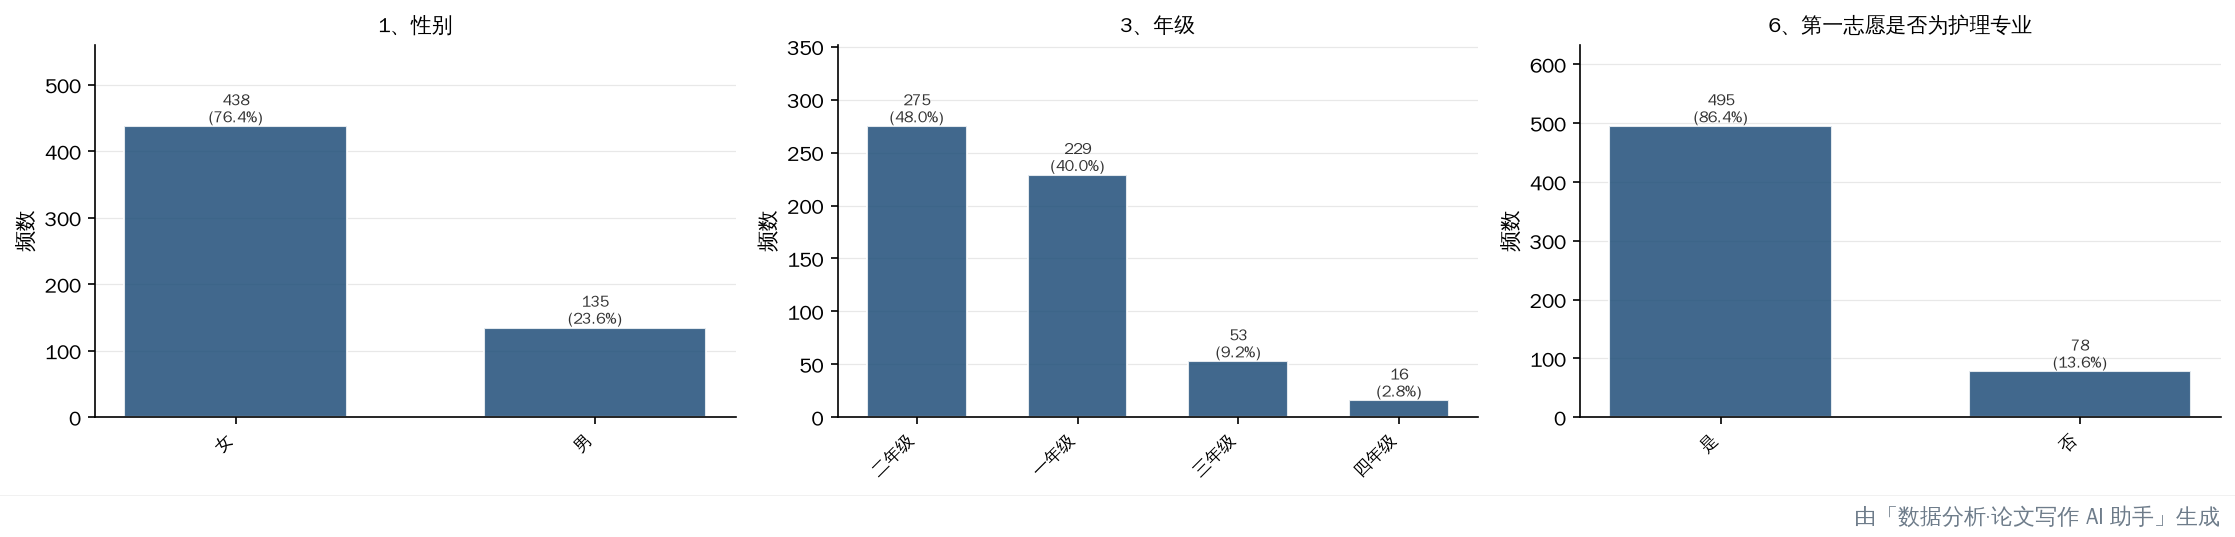
- 频数表报 n 与 %(如 438, 76.4%),并在表注交代期望频数不足 5 的处理:"某格期望频数<5,采用 Fisher 精确检验"。
- 措辞规范——大样本下微小的偏离也会"显著",结论写成"分布存在显著偏离(V=0.09,小效应)",把效应量放在措辞里,别用"差异很大"替代 V。
- 条形图(frequency_bar_chart.png)——每列按频数降序排列,柱顶标"n (占比%)"。读法:条长差 = 类别分布不均衡程度;某一类占比 >90% 时该变量几乎无区分度(如"第一志愿是护理 86.4%"),作为分组变量或协变量时价值有限。
↑ 以上截图均由「数据分析·论文写作 AI 助手」对真实调查数据(护理专业学生样本,n=573)自动分析生成 · 带自己的数据去跑一遍 →
公式与 χ²
期望频数 E 即"假设两组确无差异时,每格应有的人数"。观察值 O 偏离 E 越远,χ² 越大。df=1 时 χ²≥3.84 对应 p<.05。
前提假设
- 期望频数够大:每格 E≥5 是经验下限,不足时宜用 Fisher 精确检验。
- 样本独立:配对数据(如同一人前后测)不宜用普通 χ²,宜用 McNemar。
- 分类互斥:每个观测只落一格。
何时用 · 何时不该用
- 用:分类变量描述、列联表独立性检验、两组比例比较。
- 别用:变量是连续的——该用 t 检验或回归;配对设计——该用 McNemar。
常见误区
计算原理
卡方检验比较两类数字:观测频数 O(实际统计到的人数)和期望频数 E——"假设两变量确为独立,这格应有多少人"。E 由行合计、列合计算出,所以 E 反映"独立假设下的预期"。
χ² = Σ(O−E)²/E,将每格的偏离(平方后除以 E 做标准化)累加。偏离越大,χ² 越大,越偏离独立。但 χ² 对样本量敏感——n 翻倍时 χ² 大致翻倍,因而同样"显著"可能对应很小的效应,需再看 Cramér's V 以剔除样本量影响。
公式
数值代入 · 2×2 列联表
性别 × 是否焦虑,N=100。先看观测频数 O,再算 E、χ²、V。
对应滑块演示:拖动两组比例,改变的正是上面 O 表中的数字——O 越偏离 E,χ² 越大,判定越倾向"有差异"。但同样的比例、把 N 从 100 提升到 1000,χ² 会增大约 10 倍而"显得更显著",V 却几乎不变——这正是"χ² 受 n 影响、V 才反映效应本身"。
3相关分析
两个变量共变的强度与方向 —— r 从 -1 到 +1
为什么需要它
分类变量用频率看比例差异,连续变量则看共变——这就是相关。了解两个变量"是否一同变化"是分析的起点:睡眠时长和成绩有无关系、多强、正向还是负向,相关系数 r 可一并呈现。它是后续回归、中介、调节的入口:缺乏相关基础,进一步建模便缺少依据。
但相关也是最常被误用的统计量,因为它最容易被读作"因果"。下面的混淆开关将演示:r 可能被第三个变量"凭空"造出来。
直观理解
下图是散点图。拖 r 看点从离散状态收紧成一条线——r 越接近 ±1,点越紧贴一条直线;r 越接近 0,点越分散。随后打开"混淆变量"开关:r 似乎发生变化,但 X 与 Y 之间其实并无真实关联——是第三个变量同时影响了二者。这就是"相关≠因果"的图示版。
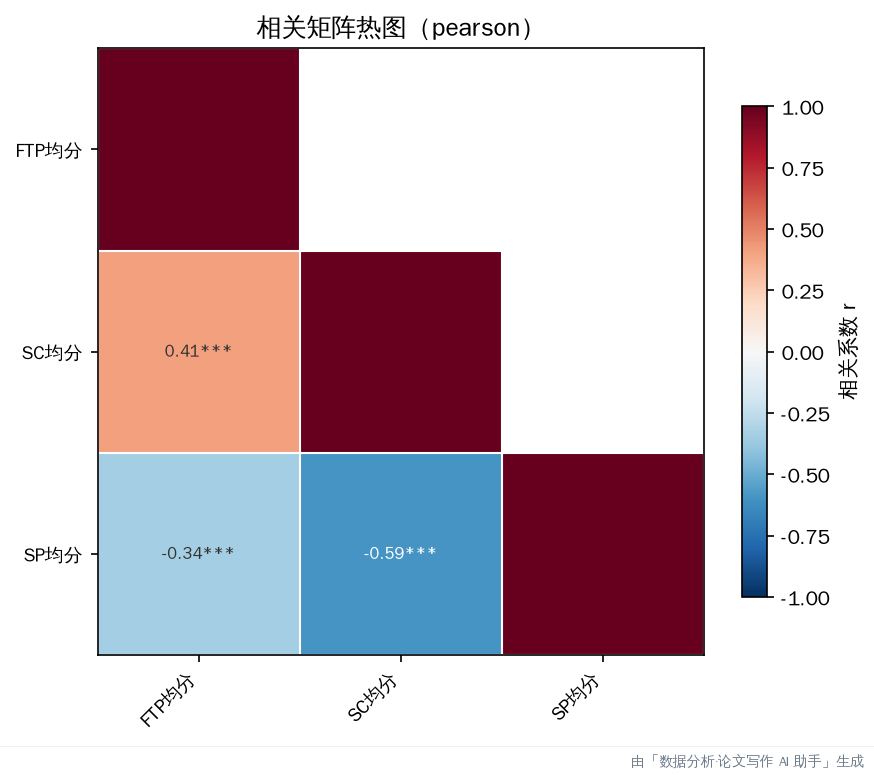
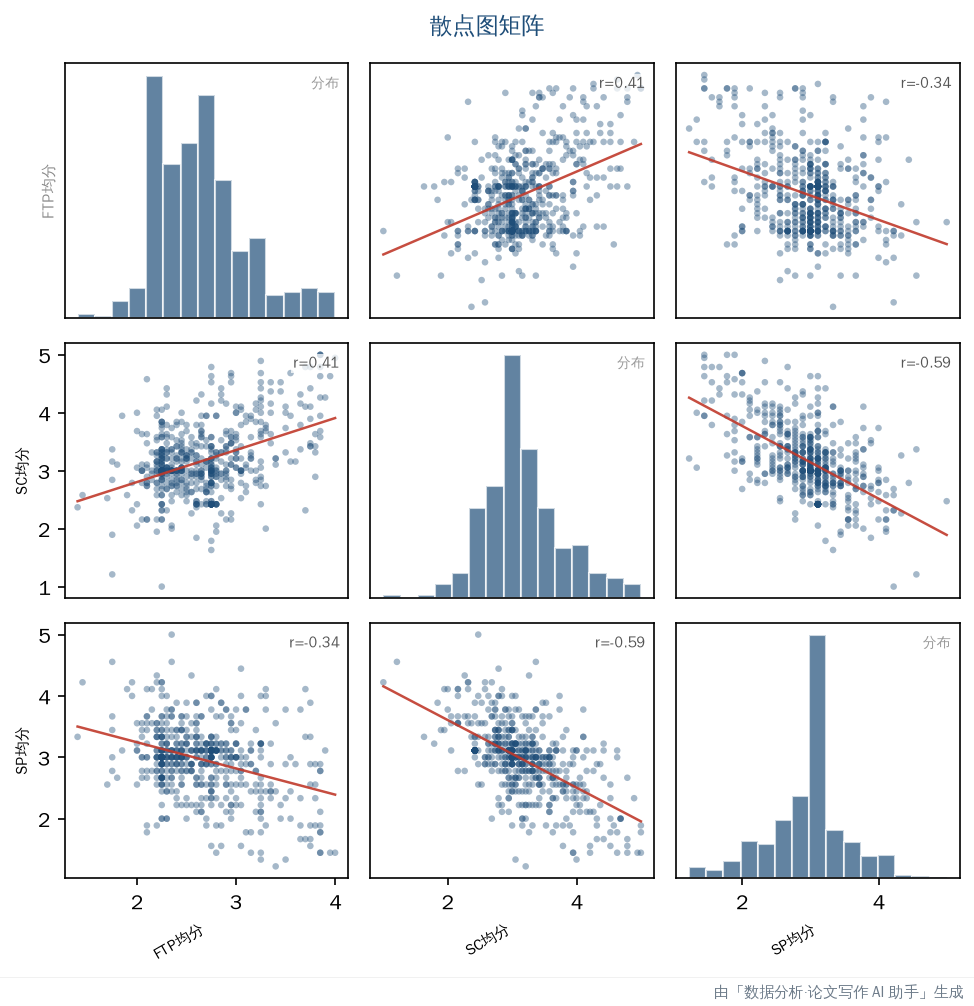
- 下三角矩阵表报全部两两相关(r + 星标 + n 于表注)——只挑显著的相关对列表是审稿雷区(选择性报告);正文引用格式如 r(571)=.41,p<.001。
- 解释强弱用 r² 而非形容词——r=.3 时写"解释 9% 的方差",不要写"较强的相关";方向(正负)先于强度描述。
- 措辞规范——相关只写"关联/共变",不写"影响/作用"(因果措辞留给回归或实验设计);显著不等于强,记得报效应量级。
- 相关矩阵热图(correlation_heatmap.png)——下三角矩阵:红 = 正相关、蓝 = 负相关、颜色越深 |r| 越大,格内标 r 值 + 显著性星标。看两件事:哪些变量对强相关(|r|>0.7 时放进同一回归要警惕共线性);与因变量的相关方向是否符合理论预期。
- 散点图矩阵(correlation_scatter_matrix.png,2–6 个变量时)——对角线 = 各变量分布,非对角 = 两两散点 + 红色 OLS 拟合线 + 右上角 r 值。读法:拟合线是直线但点呈弯曲 = 线性相关系数会低估甚至误读真实关系,此时考虑加二次项或 Spearman。
↑ 以上截图均由「数据分析·论文写作 AI 助手」对真实调查数据(护理专业学生样本,n=573)自动分析生成 · 带自己的数据去跑一遍 →
公式与 r
r 衡量的是线性共变的强度。非线性关系(如 U 型)r 可能等于 0,但关系确实存在——此时宜用 Spearman 秩相关。
前提假设
- 线性关系:非线性关系宜用 Spearman,或先画散点观察形态。
- 无极端异常值:r 对离群点较为敏感,单个点可能将 r 从 0 拉至 0.8。
- 连续变量:分类变量宜采用其他关联度量。
何时用 · 何时不该用
- 用:探索两个变量关系、筛选后续建模候选变量、信效度里的题总相关。
- 别用:试图下因果结论;多元场景下只看两两简单相关(易受混淆变量影响,宜看偏相关或回归)。
相关≠因果
计算原理
Pearson r 的本质:两个变量各自减去均值(中心化),考察协方差 Cov(X,Y)相对各自离散程度的大小。协方差为正→同向共变、为负→反向;但其带单位、不便跨研究比较,故除以两个标准差的乘积做标准化,纳入 [−1, +1]。
分子 Σ(x−x̄)(y−ȳ) 是同向偏离的累加:两变量同时高或同时低得正项、一高一低得负项。分母 sqrt(Σ(x−x̄)²·Σ(y−ȳ)²) 是两个离差平方和的几何平均,起到"归一化"作用。这样 r 既无量纲又对线性敏感,故称"标准化协方差"。
公式
数值代入 · 睡眠时长与成绩(n=5)
5 名学生,x=睡眠时长,y=成绩。先列离差表,再套公式。
对应滑块演示:拖 r 即改变散点收紧的程度——离差乘积全同号时 r→+1、全反号时 r→−1、正负混杂时 r→0。打开"混淆变量"开关后散点收紧并非因 X、Y 真实共变,而是第三变量同时影响了二者的均值,这正是 r 无法分解出因果的原因。
4组间比较
两组均值差多少才算"存在差异" —— t、p、Cohen's d
为什么需要它
实验组与对照组、男对女、干预前对干预后——两组均值存在差异,究竟是干预确有效果,还是抽样波动所致?t 检验将"均值差"与"组内波动"放在一起比较:差异显著大于波动,才认为"存在差异";差异被波动淹没,则归于随机噪声。
它与相关分析互为兄弟:相关看两个连续变量"是否一同变化",组间比较看一个分类变量"是否使一个连续变量的均值产生差异"——本质都是考察"关系",只是变量角色不同。
直观理解
下图是两组分布。拖均值差 Δ 拉开两峰、拖 σ 改变各自的宽窄,观察重叠区、t、p、Cohen's d 如何变化——两峰分离越远、各自越窄,t 越大、越容易显著;两峰重叠成一团则不显著。关注的是分离程度,而非均值的绝对大小。
t = (M₁ − M₂) / SE_diff
均值差除以差的标准误;|t| 越大两峰分离越明显,t→p 判显著。
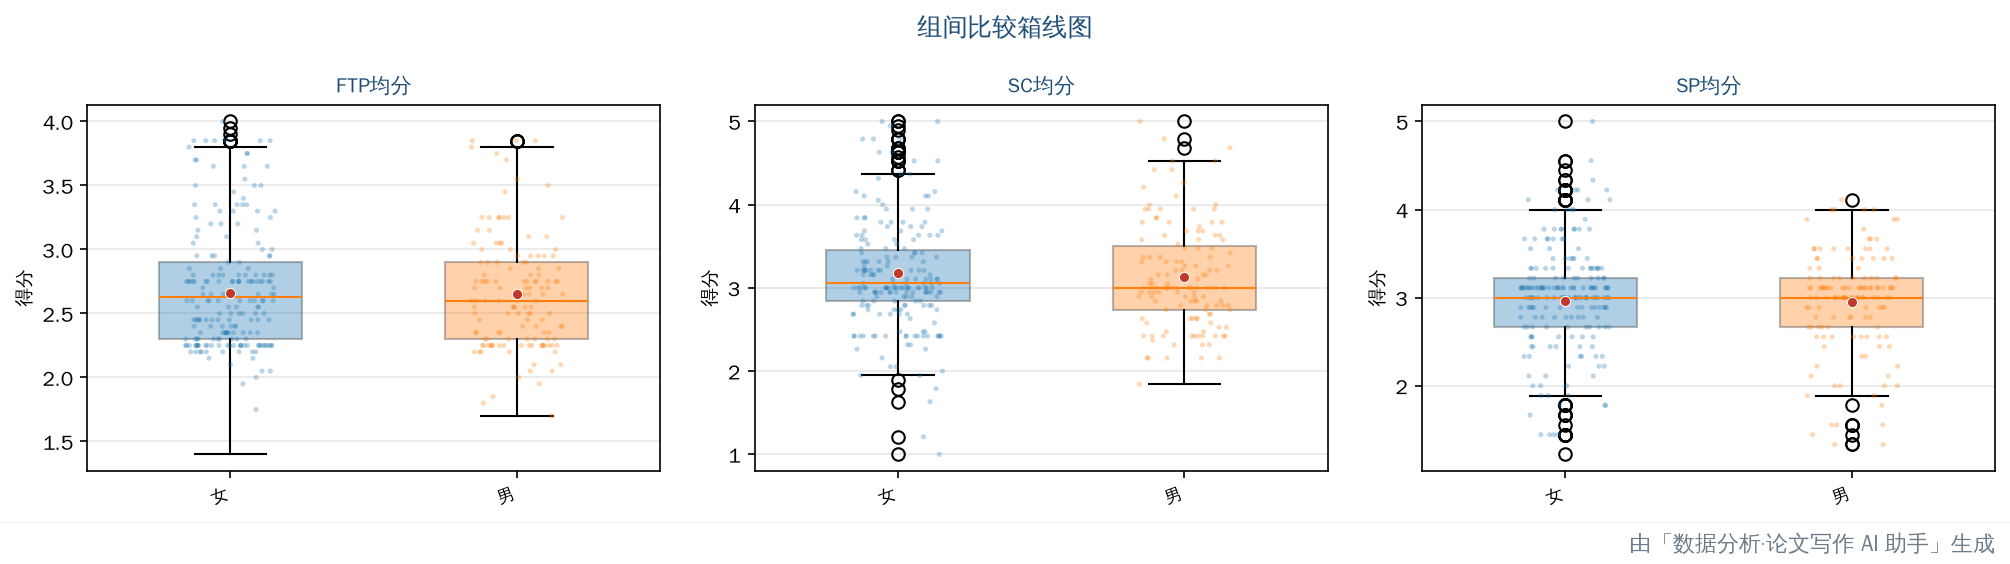
- 每组报 M(SD),检验报"统计量(自由度)+p+效应量"三件套:如 t(571)=0.12, p=.906, d=-0.01——效应量 Cohen's d(或 ANOVA 的 η²)是审稿人必查项,只报 p 不报 d 会被要求补。
- 方法选择写进方法部分:Levene 检验结果决定 t 还是 Welch t;多组先 ANOVA F(df1,df2) 再 Tukey 事后——这些决策过程要在文中可见,不能只给最终 p。
- 措辞规范——"组间差异有统计学意义(d=0.45,中等效应)";差异不显著时写"未检出显著差异",不要写"两组没有差异"(未检出 ≠ 不存在)。
- 组间比较箱线图(group_compare_boxplot.png)——每组一个箱线(按组着色)+ 浅色 jitter 散点(原始数据形态,>200 抽样)+ 红点(组均值)。读法:箱体高低差 = 组间水平差;箱体宽窄差 = 方差不齐信号(提醒你看 Levene 检验);某组散点明显双簇 = 组内异质,均值比较可能掩盖结构。
↑ 以上截图均由「数据分析·论文写作 AI 助手」对真实调查数据(护理专业学生样本,n=573)自动分析生成 · 带自己的数据去跑一遍 →
t 检验与 Cohen's d
t 将均值差按"组内标准误"标准化;d 将均值差按"组内标准差"标准化。t 管"是否真实",d 管"差异多大"。多组别直接做两两 t 会膨胀一类错误,宜用 ANOVA 先做整体检验、显著后再做事后两两比较。
前提假设
- 正态:偏态较重时宜用 Mann-Whitney U(两组)或 Kruskal-Wallis(多组)。
- 方差齐性:方差不齐时宜用 Welch 修正的 t。
- 独立样本:配对设计(前后测)用配对 t。
何时用 · 何时不该用
- 用:两组比较用 t、多组用 ANOVA、非参数场景用秩检验。
- 别用:连续自变量——宜用回归;对配对数据误用独立 t(宜用配对 t)。
常见误区
计算原理
t 检验的核心是"均值差 / 误差"。分子是两组均值之差 Δ= x̄₁−x̄₂,直接量化"差异多少";分母是该差值的标准误 SE,量化"差值本身的波动"。两者相除,即问"差是误差的几倍"——倍数越大,越不像是抽样波动。
SE 用 合并方差 S_p 计算:将两组各自的离差平方和合并后除以总自由度,得到一个"共享的组内波动估计"。这也是为何前提要求方差齐——若两组方差相差较多,硬合并为一个 S_p 会扭曲 SE,此时宜用 Welch 分别估计各自方差、修正自由度。方差是否齐看 Levene。
Cohen's d 与 t 同形但分母不同:d 用 S_p(标准差),t 用 S_p·sqrt(2/n)(标准误)。因此 d 独立于样本量,t 会随 n 增大——大样本下微小差异也"显著",但 d 几乎不变,这才是"差异多大"的稳健回答。
公式
数值代入 · 实验组 vs 对照组(各 n=5)
两组各 5 人,分数如下。先算均值与组内平方和,再 S_p、t、d。
对应滑块演示:拖均值差 Δ 直接改变 t 的分子、拖 σ 改变 S_p 即改变分母——分离越远或组内越窄,t 越大。但需注意:把 n 从 5 提到 50,SE 缩小、t 升高而"更显著",d 却几乎不变——这演示了 t/p 随样本量膨胀、d 才是稳定的效应大小。
5信度分析
量表是否稳定一致 —— Cronbach α 与题目数、题间相关
为什么需要它
前面相关、组间比较中用到的"学业表现""自我效能"分数,都由几道题汇总而成——这些分数是否稳定,直接影响前述结论是否可信。一个量表测量同一构念,在多次或多个题目之间应保持一致;若测量本身波动较大,后续所有相关、回归、中介的系数都会被衰减压低——信度偏低,地基就不牢,其上的估计也会偏离。信度分析正是评估这块地基是否稳固。
它安排在相关、回归之前是有道理的:"学业表现""自我效能"都是几道题汇总的分数,题目汇总是否稳定,直接决定后续能否用该分数进行更复杂的建模。
直观理解
下图把 r̄ 从抽象数值呈现为题 × 题相关矩阵热力图——每个格子是一对题目的相关,越红相关越强、对角线=1。拖 k(题目数)和 r̄(平均题间相关),观察矩阵色块和 α 如何变化。题目越多、题间相关越高,α 越高;但点开下方两个预设——「少而精·4题」和「多而水·20题」——会得到同样的 α≈0.80,矩阵却差异很大:一个 4 格深红、一个 400 格暗淡。α 本身区分不出哪个更扎实。
- 每个量表(及各维度、各时点)分别报 α 与条目数,如"α=.83(14 条目)";多分量表只报一个总 α 会被视为不严谨。
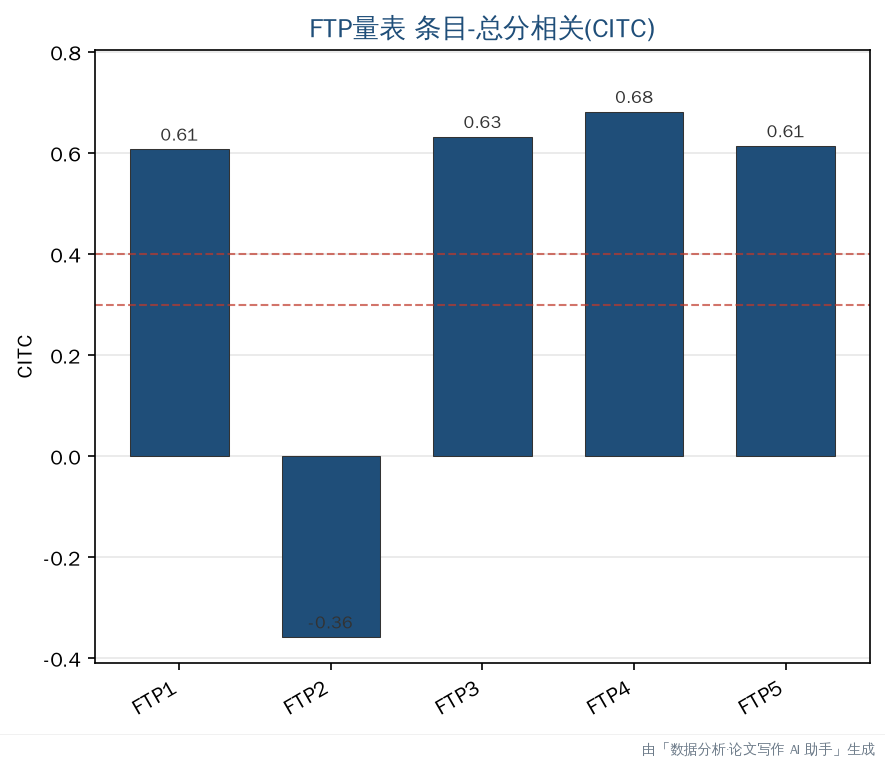
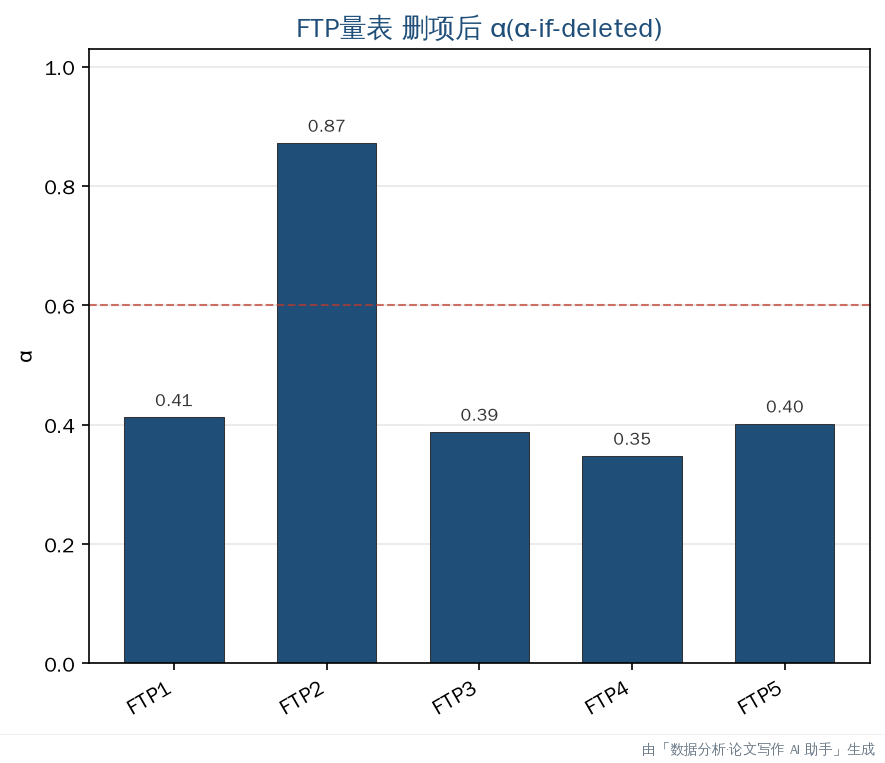
- 方法部分交代反向题处理与计分方向——真实教训:反向题未反转时某条目 CITC 可低至 -0.36、α 假性偏低,反转后恢复正常。审稿人看到异常低的单条目 CITC 会第一时问反向题。
- 措辞规范——α 只写"内部一致性可接受(α=.83)",不写"量表有效"(α 不证明效度);不以整体 α 证明单维(多维量表整体 α 会虚高,单维性引 EFA/CFA);α 过低时在 limitations 交代测量误差对后续分析的影响。
- 条目-总分相关图(reliability_citc_{量表}.png)——每条目的 CITC 条形 + 0.4 参考线:CITC < 0.4 的条目与量表测的东西"不合群",是删题首选候选(结合删项后 α 对比确认)。
- 删项后 α 图(reliability_alpha_if_deleted_{量表}.png)——删除该条目后的整体 α:某条目对应的柱明显高于当前 α(红参考线)时,删掉它量表更可靠;柱都低于当前 α = 每个条目都在贡献,无需删题。
↑ 以上截图均由「数据分析·论文写作 AI 助手」对真实调查数据(护理专业学生样本,n=573)自动分析生成 · 带自己的数据去跑一遍 →
Cronbach α 公式
α 本质上衡量"题目之间的一致程度"——题数越多、题间相关越高,α 越高。但 α 高不等于量表好,它只说明"测得稳",不说明"测的是你想测的对象"(后者属效度,是后续结构方程模型 CFA 的范畴)。
前提假设
- 单维性:多维度量表要分维度分别算 α,整体算会虚高。
- 题目同向计分:反向题要先反向计分。
- 连续或近连续:二分题用 KR-20。
何时用 · 何时不该用
- 用:量表正式使用前、论文信效度章、判断该删哪题(看删题后 α)。
- 别用:单题指标(不存在内部一致性);试图证明量表测的是正确对象(宜做效度/CFA)。
常见误区
计算原理
Cronbach α 的逻辑:将量表总分方差拆成两部分——各题方差之和 Σσᵢ²(题目各自波动的"噪声")与总分方差 σtotal²(整个量表在人与人之间的"信号")。若各题都在测同一构念,总分方差应远大于各题方差之和——人际差异远超题目本身的随机波动。
比值 Σσᵢ²/σtotal² 即"噪声占信号的比例"。1 减去它得到"信号中真正一致的部分",再以 k/(k−1) 修正题数(题数越多,越能平均掉各自的噪声),即得 α。等价的 r̄ 简便式 α=k·r̄/(1+(k−1)·r̄) 将"题间相关"浓缩为单一平均相关 r̄,便于在仪表盘上直观拖动理解。
公式
数值代入 · 4 题 × 5 人
5 人各答 4 题(1–7 计分)。先算各题方差与总分方差,再套方差式。
对应滑块演示:拖 k 即改变公式里 k/(k−1) 与题数项——加题会让噪声被更多题目平均掉、α 上升;拖 r̄ 改变的是题间相关,r̄→1 时 α→1、r̄→0 时 α→0。但这只反映"稳不稳",单维性与效度仍需 EFA/CFA 单独验证,α 无法替代。
6回归分析
控制其他变量后 X 对 Y 的净效应 —— OLS 与 R²
相关 vs 回归:先分清再动手
这是初学者最常混淆的一对。一句话区分:
- 相关回答"有无关系、多强"——两个变量共变的强度与方向(r),不区分谁影响谁、不控制其他变量,角色对称。
- 回归回答"控制其他变量后,X 对 Y 的净效应多大"——有明确方向(X→Y)和单位(b₁:X 每变化 1 单位 Y 变化多少),并控制混淆,角色非对称。
示例:自我控制与压力感相关 r = −.42,仅能说明"二者共变、负向、中等强度"。换成回归 b₁ = −0.28,才可表述为"控制了睡眠、性别后,自我控制每升 1 分,压力感降 0.28 分"——有单位、有方向、是净效应。若要预测、控制混淆或对"X 影响 Y"作出判断,宜用回归;若只想了解两变量是否共变,相关即可。
为什么需要它
信度保证测量稳定之后,回归在此基础上控制混淆、估计净效应。相关 r 仅用两个变量计算,第三变量的连带影响都混在 r 里未被剥离——例如自控与压力的 r 中,可能暗藏"睡眠差同时拉低自控、抬高压力"这条路径。回归将睡眠、性别等作为协变量纳入模型,在"它们相同"的前提下估计 X 对 Y 的效应,连带路径被剥离,b₁ 才是净效应。这是从"相关"走向"因果推断"的关键一步——虽未达到因果,但比裸相关更接近一步。
此外,回归是后续调节、中介的引擎:调节是带交互项的回归,中介是两个回归联立。理解回归之后,后两者即为它的变体。
直观理解
下图是散点加 OLS 拟合线。拖斜率 b₁ 看线转动、拖残差 σ 看点散开程度,观察 R² 如何变化——R² 越大,点越紧贴线、模型解释的方差越多。R² 是"拟合好坏"的图形化呈现。残差竖线是每个点离线的距离,越短模型越准。
Y = b₀ + b₁X + e
R² = 1 − SSE / SST
b₁=每单位 X 的 Y 变化;R²=模型解释的方差比例。
- 系数表列全:B、SE、标准化 β、p、95% CI;模型层报 R²、调整 R²、F(df1, df2)——只报"显著"不给系数与 CI,等于没报。
- 正文解读顺序固定:先模型整体(F、R²)→ 逐系数方向与显著性 → 与理论对话;预测变量间比较用标准化 β("SC 的 β=-0.54 强于 FTP 的 -0.12"),非标准化 B 只用于写预测方程。
- 措辞规范——报控制变量效应时写"控制自我控制后,FTP 对睡眠拖延的效应降至 β=-0.12";VIF 结果在方法或表注交代(全部 <5 时一句话即可)。
- 回归诊断四联图(regression_diagnostics.png,R plot(lm) 惯例)——①残差-拟合(lowess 平滑线应近水平 = 线性+等方差);②正态 Q-Q(点沿红线 = 残差正态);③Scale-Location(无上升趋势 = 同方差);④残差-杠杆(红色虚线 = Cook's d 等高线,线外标号点为强影响点,需核对原始数据)。先看拟合、再解读系数是回归的规矩。
- 系数森林图(regression_coef_forest.png)——标准化 β ± 95% CI 横排,蓝 = 显著、灰 = 不显著:哪个预测变量更重要(比 |β|)、哪些显著,一图可读。
- 共线性表(VIF)——VIF>10 严重共线、>5 需留意;预测变量高度相关时系数解释会失稳。
- 报告同时给出 R²/调整 R²、F 检验与全部系数的 B/SE/标准化β/p/95% CI,SPSS 风格。
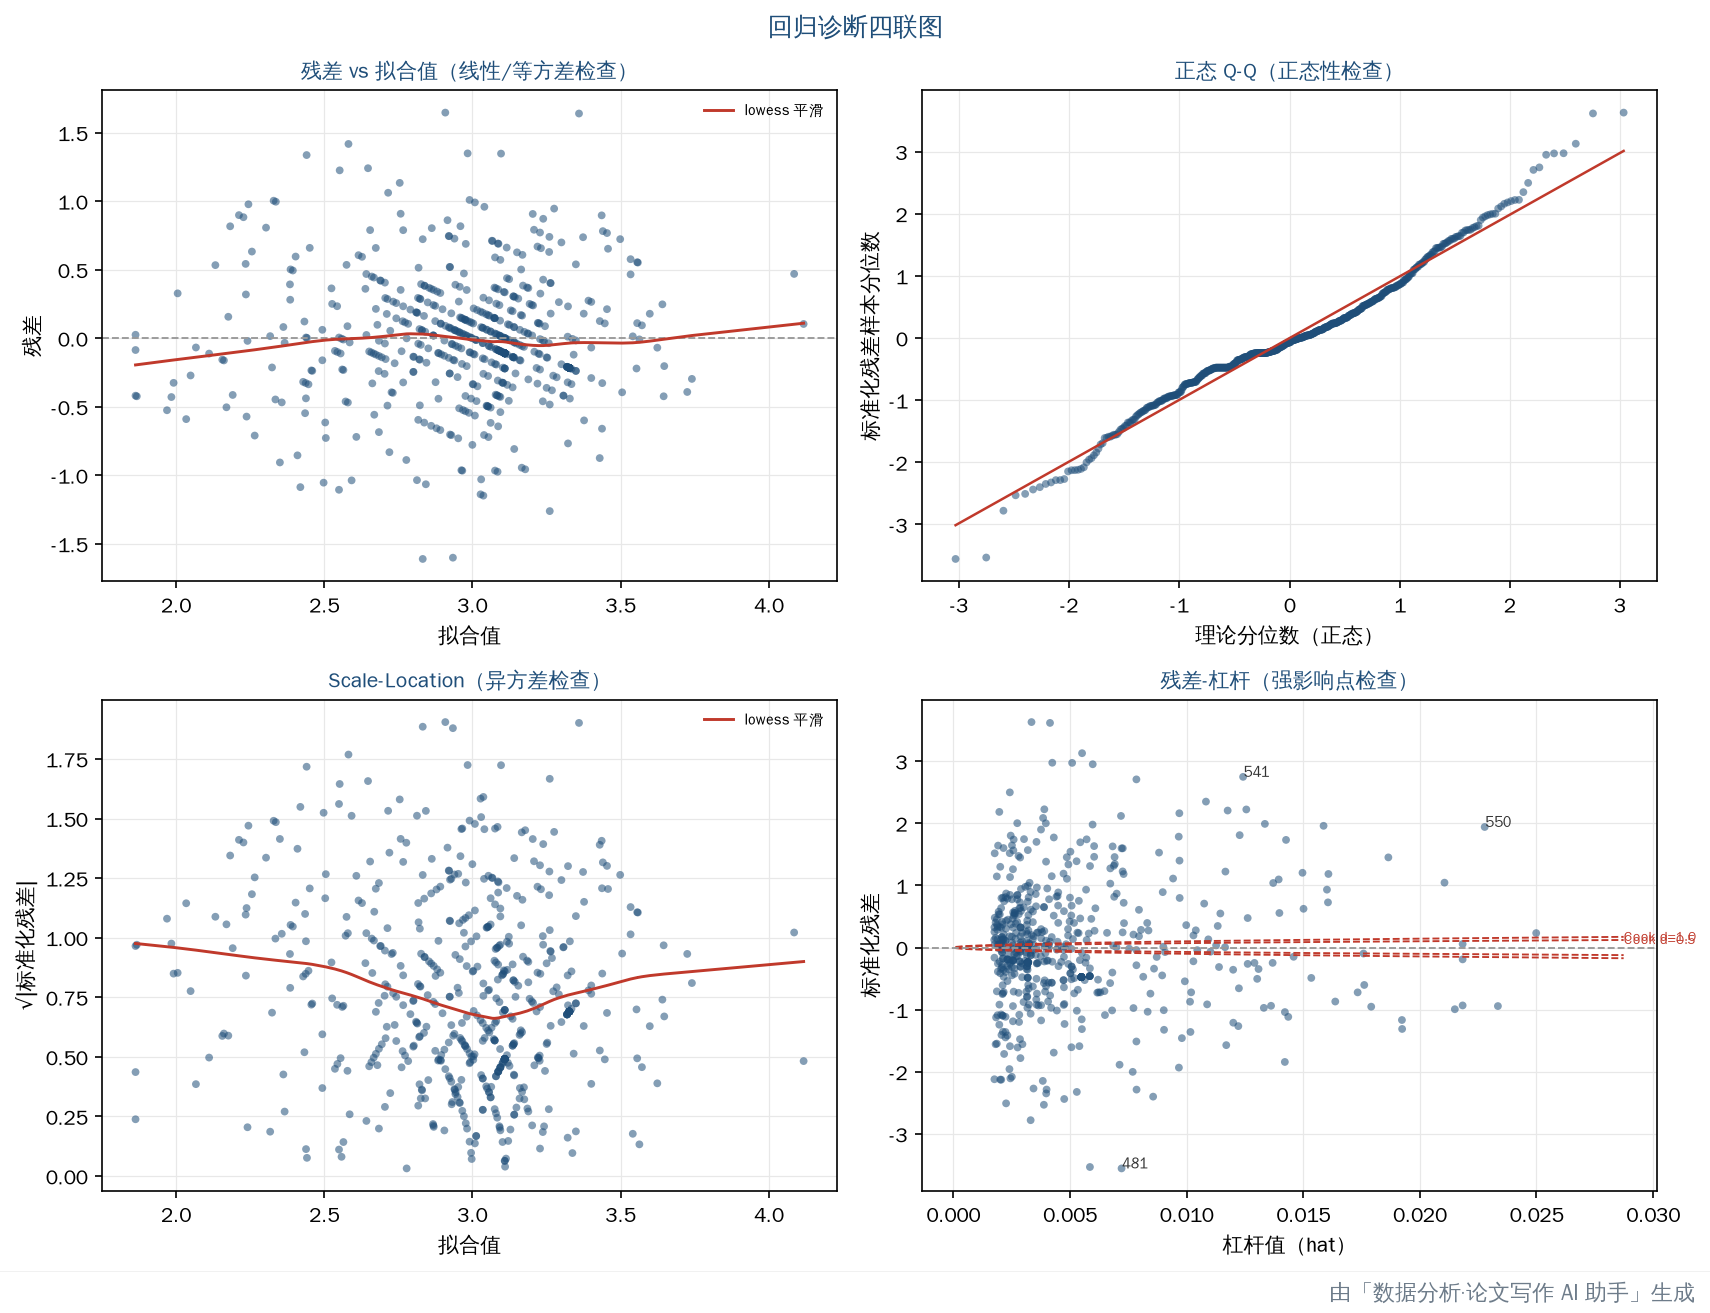
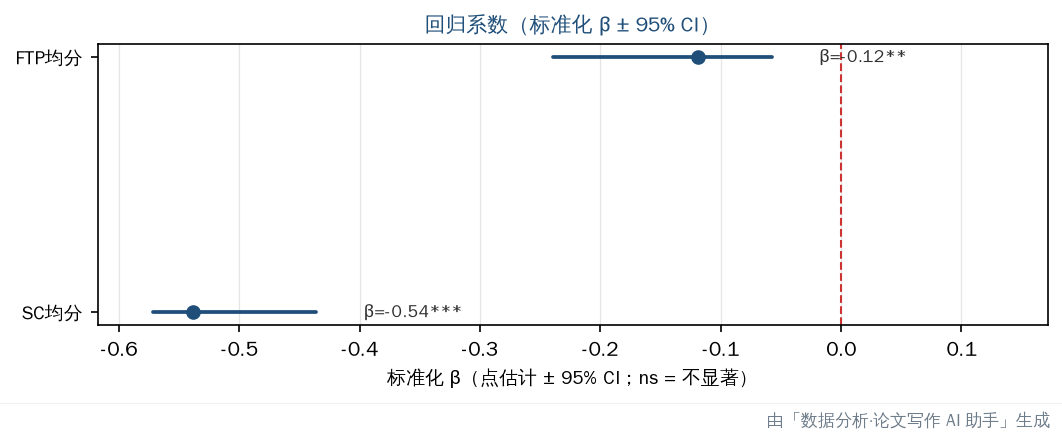
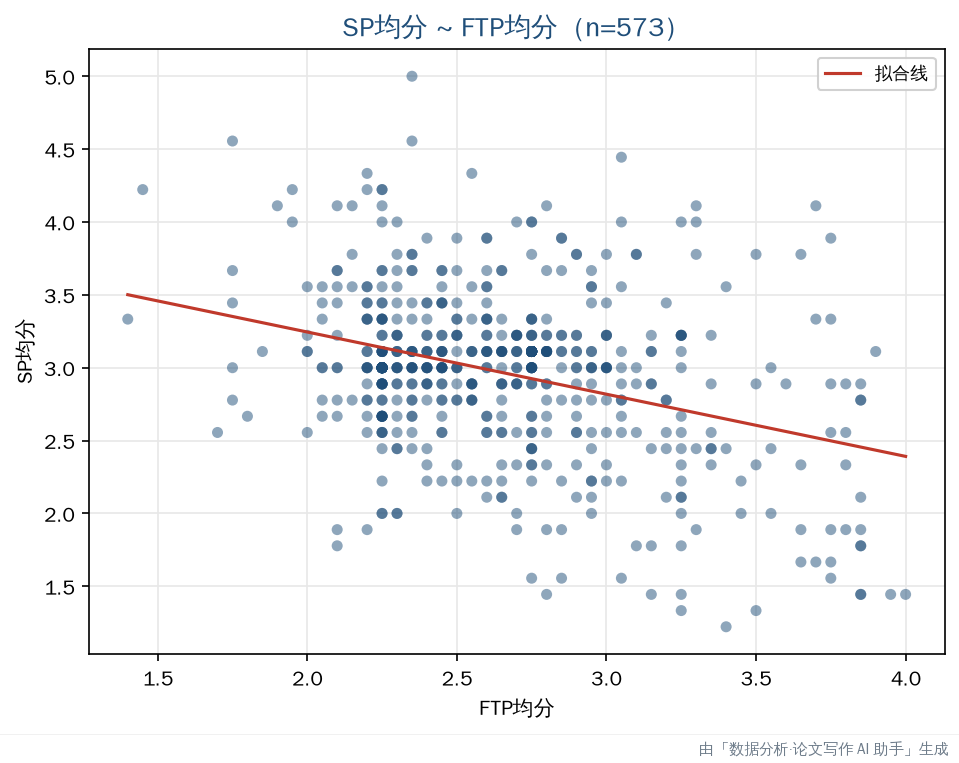
↑ 以上截图均由「数据分析·论文写作 AI 助手」对真实调查数据(n=573)自动分析生成的真实回归报告 · 带自己的数据去跑一遍 →
OLS 与 R²
b₁ 是"X 每变化 1 个单位、Y 变化多少"的净效应(控制了模型中其他变量后)。R² 是模型整体解释力。看回归不宜只看 p,应同时关注系数方向、大小和 R²。
前提假设
- 线性:X 与 Y 的关系是线性的。
- 残差独立同分布:用 Durbin-Watson 检查自相关。
- 无强共线:自变量之间不宜过度相关,用 VIF 检查(>10 需警惕)。
- 同方差:残差方差恒定,用 Breusch-Pagan 检查。
何时用 · 何时不该用
- 用:预测 Y、估计 X 对 Y 的净效应、为中介/调节打基础。
- 别用:分类结局变量(宜用 Logistic);关系明显非线性(宜更换模型或做变换)。
控制与净效应
计算原理
回归要找一条最能代表数据的线。如何衡量"最能代表"?让所有点离这条线的距离(残差 e)尽量小。但残差有正有负,直接相加会抵消,故先平方再求和——这就是最小二乘(OLS):使残差平方和 SSE 达到最小。
对 b₁ 求导、令其等于 0,解得 b₁ = 协方差 / 方差。直觉是:X、Y 共变越强(分子大)、且 X 自身越分散(分母大、估计越稳),斜率越大;截距 b₀ 使线穿过数据中心 (X̄, Ȳ)。有了 b₁、b₀ 即可算出每个点的预测 Ŷ 与残差 e,进而计算 SSE、R²、以及 b₁ 的标准误 SE(b₁) 与 t。
公式
数值代入 · 5 个点走一遍
数据 X = 1, 2, 3, 4, 5;Y = 2, 4, 5, 4, 5(n = 5)。下面每步都从原始数据算到结果。
对应上面的滑块演示:b₁ = 0.60 即那条拟合线的斜率,R² = 0.60 即点贴线的程度、模型解释的方差比例。拖动滑块改变的本质就是这两个数——由此可知它们如何从原始数据一步步算出。
7调节效应
W 改变 X→Y 的强弱甚至方向 —— 效应对谁、在什么条件下更强
调节 vs 中介:先分清再动手
这是最容易混淆的一对。一句话区分:
- 中介回答"为什么"——X 通过什么中间变量影响 Y(机制链)。变量角色是"传导者"。
- 调节回答"对谁 / 何时"——X 对 Y 的效应在不同人群或情境下是否不同(边界条件)。变量角色是"开关"。
示例:干预对学业的影响,是否随学生学习动机的高低而变强变弱?动机并不解释干预"为什么"起作用(那是中介的范畴),它决定干预"对哪类人"更有效——这就是调节。
直观理解
下图取 W(学习动机)的低(−1SD)/ 高(+1SD)两个值,画出 X→Y 的两条简单斜率线,每条线斜率 = b₁ + b₃·W。拖 b₁:两线一同倾斜、缺口不变(b₁ 不产生调节);拖 b₃:两线扇开——b₃ 越大两线越散,b₃>0 时高 W 线更陡、b₃<0 时低 W 线甚至反转。调节的证据就在两线扇开的缺口里,拖动一下胜过文字描述。
Y = b₀ + b₁·X + b₂·W + b₃·(X×W)
X×W = X 与 W 的乘积(交互项),当新自变量进回归。对 X 求导 → ∂Y/∂X = b₁ + b₃·W:X 的效应随 W 变,即调节。b₃ = 斜率随 W 变化的速率。
- 交互项是主角:表中报 b₃ 的 B/SE/p + ΔR²(交互项加入后解释率的增量);简单斜率表报各 W 水平的斜率/SE/p(或 CI)——只报主效应 b₁ 的表等于没做调节分析。
- 方法部分交代:连续变量做了中心化、交互项构造方式、简单斜率取 ±1SD 的依据——这些决策不写,结果无法复现。
- 措辞规范——b₃ 不显著写"调节效应未获支持",不写"年龄对两者关系没有影响"(未检出 ≠ 不存在);b₃ 显著时按简单斜率方向写"对高 X 者更强/反转",并配交互图。
- 交互作用图(moderation_simple_slopes.png)——W 取 −1SD/均值/+1SD 时的三条预测线。线不平行 = 交互存在;图例直接标注各水平的简单斜率 b 与星标,不必回表查显著性。
- 简单斜率森林图(moderation_slope_forest.png)——三个水平的斜率 ± 95% CI 横排。CI 跨 0(灰色)= 该 W 水平下 X 对 Y 的效应不显著;一眼看出"效应对哪档人显著"。
- Johnson-Neyman 区间图(moderation_johnson_neyman.png)——比 ±1SD 两个点更完整:实线 = 条件效应随 W 的全程变化,阴影 = 95% CI,橙色竖虚线 = 显著性转变边界。W 在任意取值处效应是否显著,一图可读;这正是数学进阶里 J-N 方程的图形化。
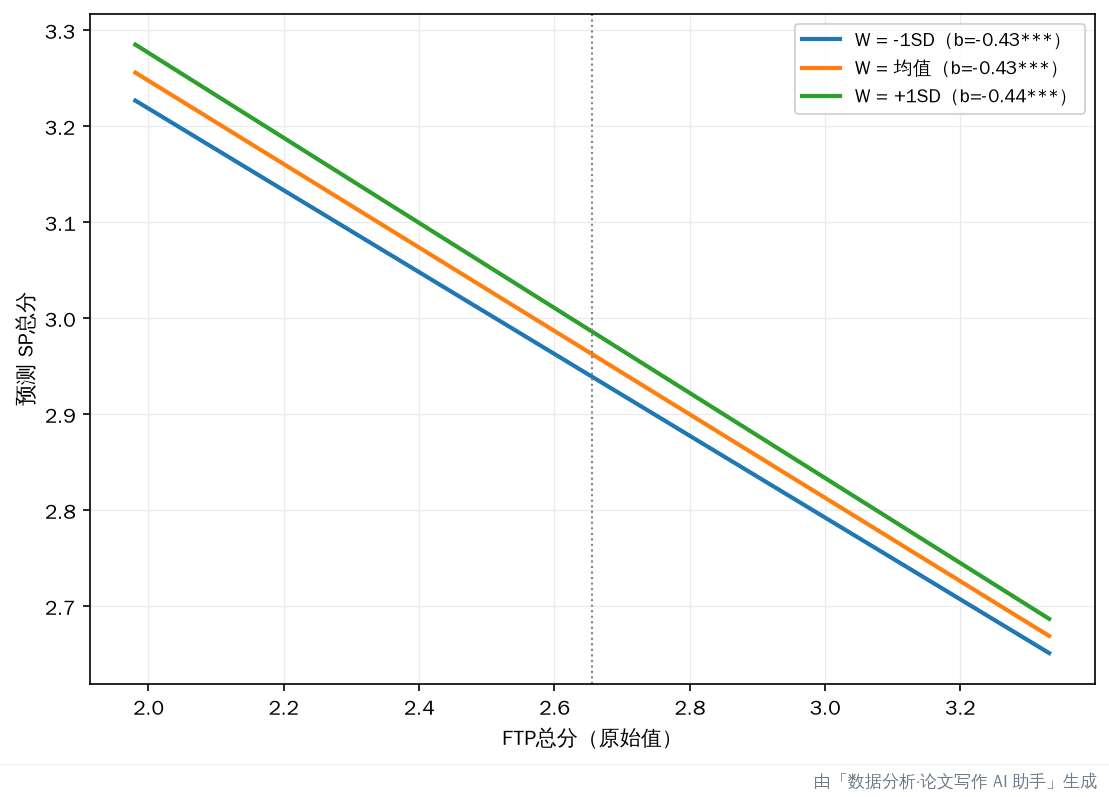
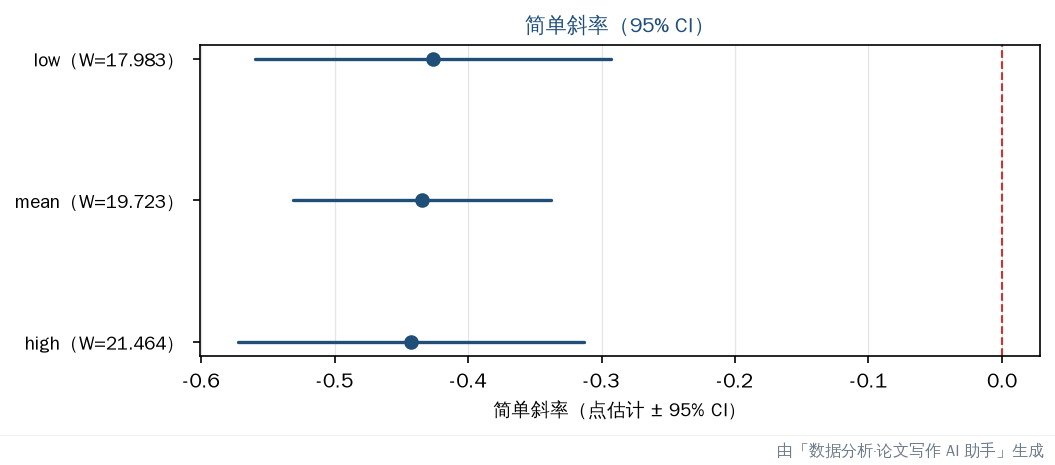
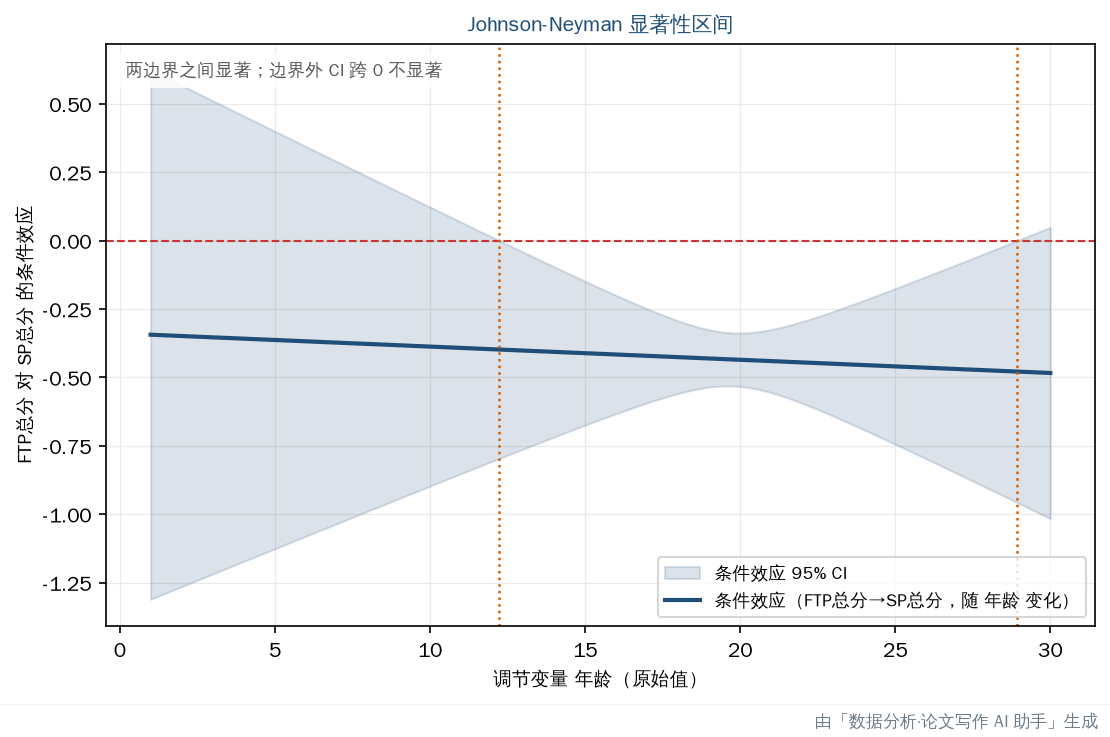
↑ 以上截图均由「数据分析·论文写作 AI 助手」对真实调查数据(护理专业学生样本,n=573)自动分析生成 · 带自己的数据去跑一遍 →
公式与简单斜率
调节用一个带交互项的回归:
b₃ 即调节效应——它衡量"X→Y 的斜率随 W 变化的速率"。b₃ 显著,提示调节存在。随后做简单斜率分解:取 W 高(+1SD)和低(−1SD)两个值,分别画 X→Y 的斜率线,观察是否翻转——即上面图中拖动的那条线。
前提假设
- 中心化或分类编码:连续 W 中心化;分类 W 用 dummy 编码,避免无意义的"0 点"。
- 不共线:X 与 W 不应高度相关(中心化能缓解但不解决本质共线)。
- 先显著再分解:b₃ 显著后再做简单斜率分解,不宜在调节不显著时仍画两条线作解释。
常见误区
条件效应:调节的数学定义
无调节的基线模型里,X 对 Y 的效应是常数:\(\partial Y/\partial X = \beta_1\),与 W 取值无关。加入乘积项 \(X \cdot W\) 后对 X 求偏导——
\(\beta_1\) 是 \(W=0\) 时的基准斜率,\(\beta_3\) 是「W 每 +1 单位、斜率变化多少」——即调节强度。交互项数学上对称:X 同样调节 W → Y。「谁调节谁」由研究者的理论指定,不由数学决定。
几何视角:从一族平行直线到扇形、马鞍面
无调节时把方程按 X 重排:\(Y = (\beta_0 + \beta_2 W) + \beta_1 X\)——斜率恒为 \(\beta_1\)、截距随 W 平移,在 (X, Y) 平面上是一族平行直线(三维中是平面)。有调节时重排:
斜率与截距都随 W 变,直线从一点扇形展开——像打开的折扇;三维空间中是双曲抛物面(马鞍面)。折扇的铰接点(所有直线相交处)在 \(X = -\beta_2/\beta_3\)。\(\beta_3\) 的几何意义就是「扇开的速度」:\(\beta_3=0\) 折扇合拢(无调节)、\(\beta_3>0\) 时 W 越大斜率越陡、\(\beta_3<0\) 时斜率随 W 增大而变缓乃至反转。
估计与中心化:OLS 闭式解与共线性
调节模型仍是线性模型——把 \(X \cdot W\) 当作新变量放进设计矩阵,OLS 闭式解与估计量协方差:
中心化(\(X_c = X - \bar{X}\)、\(W_c = W - \bar{W}\))后展开可证:\(\beta_3' = \beta_3\)(交互项系数不变),但 \(\beta_1' = \beta_1 + \beta_3 \bar{W}\)——主效应含义从「W=0 处」变成「W 均值处」。预测值 \(\hat{Y}\) 完全不变,中心化只是重新参数化。它降低共线性的机制是消除「均值非零造成的尺度伪相关」:未中心化时 \(\operatorname{Cov}(X, XW)\) 常很大,中心化后 \(\operatorname{Cov}(X_c, X_c W_c) \approx 0\)。
简单斜率与 Johnson-Neyman 区间
简单斜率 \(\theta(w_0) = \beta_1 + \beta_3 w_0\) 是 \(\hat{\beta}_1\)、\(\hat{\beta}_3\) 的线性组合,其方差由 Aiken & West (1991) 公式给出:
SE 是 \(w_0\) 的二次函数——\(w_0\) 越偏离最小方差点、SE 越大,所以简单斜率的 CI 在 W 两端张成喇叭状。标准做法取 \(W = \bar{W} \pm 1\mathrm{SD}\) 三点(pick-a-point / spotlight),但 ±1SD 是任意选的点:某些 W 处显著、另一些不显著,转变点被忽略。J-N 区间把它找出来——令 \(|t| = t_{cr}\) 两边平方展开,得到关于 w 的二次方程 \(A w^2 + B w + C = 0\):
两个根 \(w_1 < w_2\) 即显著性转变点:\(w \in (-\infty, w_1) \cup (w_2, +\infty)\) 时简单斜率显著、区间内不显著;判别式 \(< 0\) 则全程显著(或不显著),无转变点。
变体与检验力
分类调节变量:W 二分类时 \(X \cdot W\) 等价于分组回归——W=0 组斜率 \(\beta_1\)、W=1 组斜率 \(\beta_1 + \beta_3\),\(\beta_3\) 的检验就是两组斜率差的 t 检验;多分类则造 k−1 个交互项做联合 F 检验。
曲线调节:\(Y = \beta_0 + \beta_1 X + \beta_2 X^2 + \beta_3 W + \beta_4 XW + \beta_5 X^2 W + \varepsilon\)——\(\beta_5\) 检验「二次曲率是否被 W 调节」(U 型关系随年龄变陡)。三阶交互:\(\beta_7 (XWZ)\) 表示「W 对 X → Y 的调节」本身又被 Z 调节,\(\partial^2 Y/\partial X \partial W = \beta_4 + \beta_7 Z\)。
有调节的中介:W 调节 a 路径时条件间接效应 \(\mathrm{IE}(W=w) = (a_1 + a_3 w) \cdot b\)(PROCESS 模型 7/8/14)。检验力:交互效应量通常只有主效应的 1/4–1/2,检出交互所需样本约为主效应的 4 倍;测量信度从 .90 降到 .70 时交互检验力下降约 40%——连续×连续最难显著、分类×分类最容易,建议 \(n \geq 200\)。
pwr.f2.test 按 \(f^2 = \Delta R^2/(1-R^2_{\text{full}})\) 估算样本量。8中介效应
X 通过 M 影响 Y —— 间接效应 a×b 是否真实存在
为什么需要它
已知 X 与 Y 有关。但"有关"只是结果,并未说明原因。工作压力为何影响学业表现?可能是因为它先影响睡眠,睡眠再影响学业。这条 "X → M → Y" 的传导链,正是中介要拆解的内容。
中介分析的产出不是一个数值,而是一条机制:它将笼统的"X 影响 Y"拆分为"X 先影响 M、M 再影响 Y",使因果链条的中间环节得以清晰呈现。
直观理解
下面这张图即中介结构。X 在左、M 在中间、Y 在右。弧线 c′ 是 X 直接影响 Y 的部分,箭头 a、b 是经过 M 的间接通路。间接效应 = a × b。拖动 a、b 两个滑块,观察底部"间接效应条"上的置信区间何时跨过 0、绿色判定灯何时亮起——即"中介成立"的临界。
M = a·X
Y = c′·X + b·M
间接 = a·b,总效应 c = c′ + a·b
判中介看 间接效应 a×b 的 CI 是否含 0,不看 a、b 各自显著。
- 间接效应的点估计 + Bootstrap 95% CI 必报(如 ab=-0.116, 95% CI[-0.18, -0.06]),并交代 Bootstrap 次数(5000 为惯例)——只报 a、b 各自的星标或 Sobel p 是过时且不充分的做法。
- 三条路径系数 a、b、c′ 全部报出,并写明中介类型:c′ 显著 = 部分中介(附中介占比),c′ 不显著 = 完全中介。
- 措辞规范——写"间接效应显著,提示 X 通过 M 影响 Y",不写"证明了中介机制"(统计支持 ≠ 因果证明,非纵向/实验设计时尤甚);链式中介每段间接效应分别报 CI。
- 中介路径图(mediation_path_diagram.png)——X 左、Y 右、M 上中的三角布局。先看线型再看星标:实线 = 路径显著(p<.05),虚线 = 不显著;图底方框给出间接效应 a×b 及其 95% CI 与总效应/中介占比。链式中介画 X→M1→M2→Y 主链加 b₁、c′ 弧线并标注分段间接效应;调节中介会多一个 W 框、虚线箭头指向 a 路径(交互),图底给调节中介指数。
- 间接效应森林图(mediation_indirect_forest.png,链式/并行中介)——每条中介路径的间接效应 ± bootstrap 95% CI 并排,蓝 = CI 不含 0(显著)、灰 = 跨 0。"哪条中介路径更强"一图可读,不必逐行对表。
- 效应分解图(mediation_decomposition.png)——总效应 c = 直接效应 c′ + 间接效应 a×b 三条横条同尺度并列,中介占比写在标题里;"中介解释了多少总效应"直观呈现。
- 条件间接效应图(mediation_conditional_effects.png,调节中介)——W 在 −1SD/均值/+1SD 三个水平的间接效应 ± CI:看哪些 W 水平下中介成立。
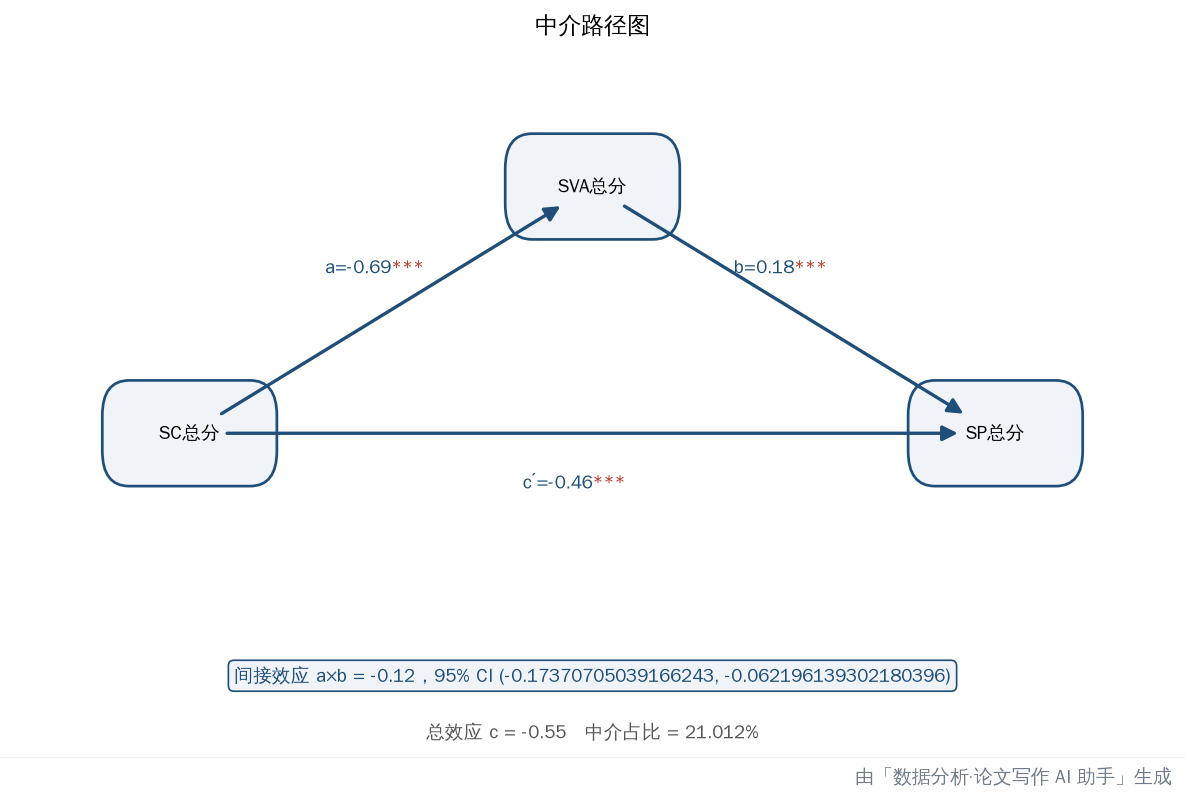
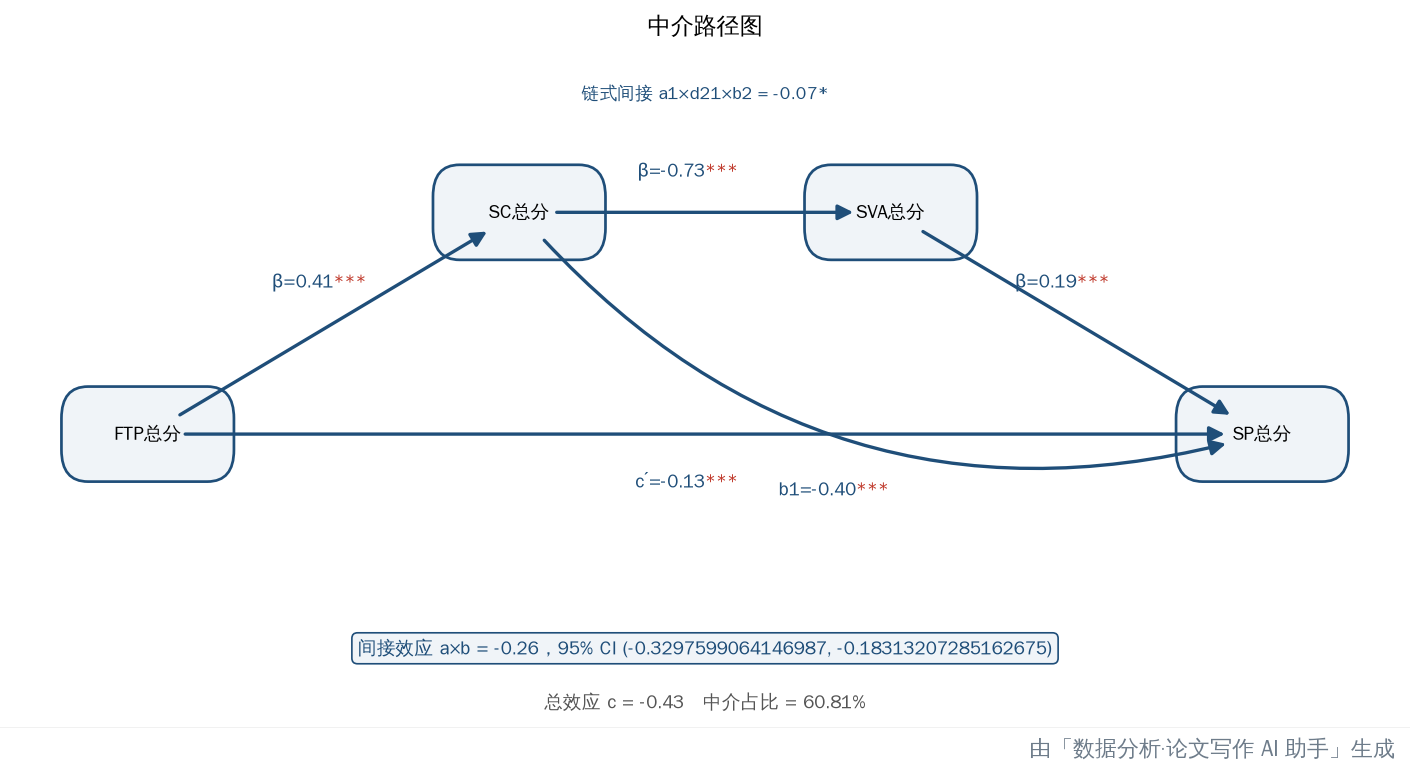
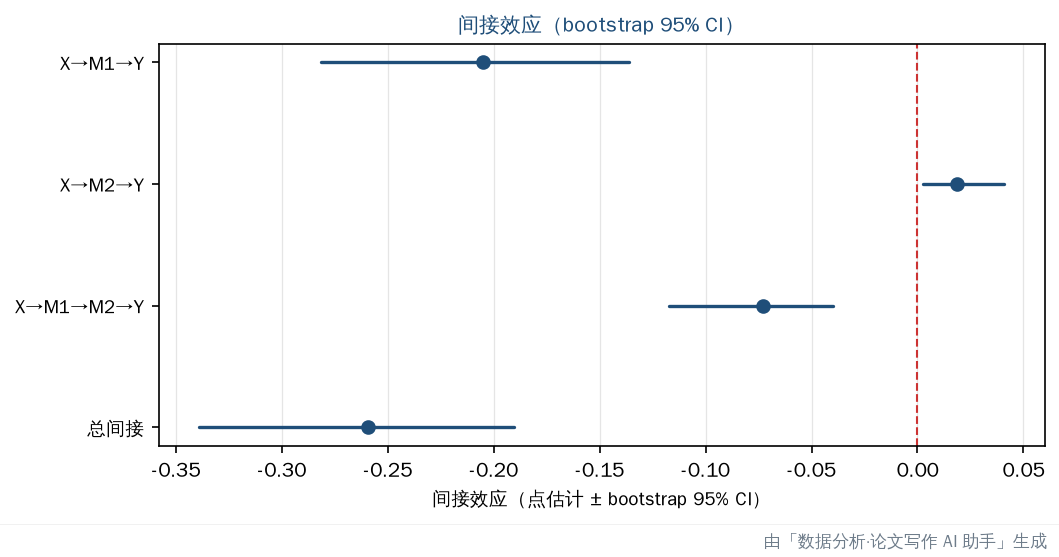
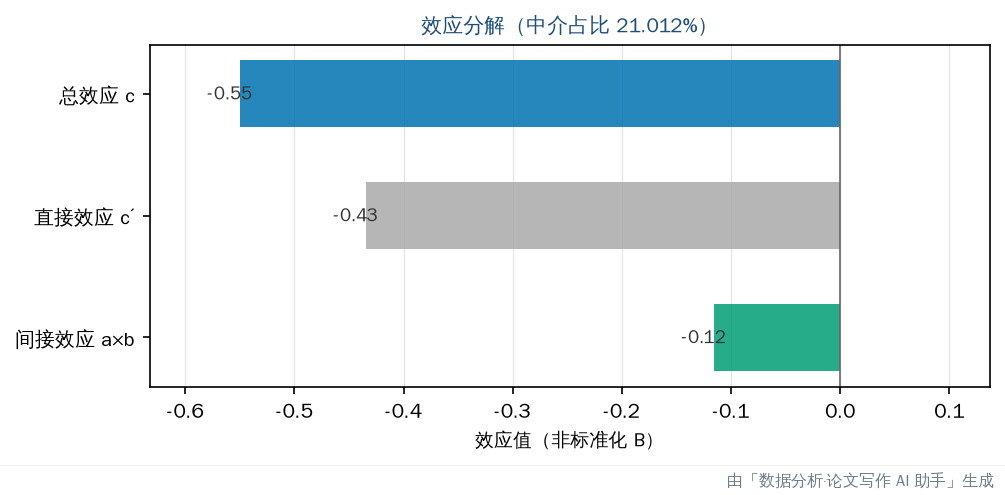
↑ 以上截图均由「数据分析·论文写作 AI 助手」对真实调查数据(护理专业学生样本,n=573)自动分析生成 · 带自己的数据去跑一遍 →
公式与检验
中介用两个回归方程联立:
检验的关键不是看 a、b 各自是否显著,而是看间接效应 a×b 的置信区间是否含 0。区间不含 0,间接通路便较为可靠地存在。现代做法用 Bootstrap 直接对 a×b 构造置信区间(重复抽样 5000 次),不依赖正态假设。
前提假设
- 时序合理:X 在时间上先于 M,M 先于 Y。横截面数据做中介,因果推断偏弱。
- 测量可靠:M 的测量信度低会压低 b、让间接效应被低估。
- 混淆控制:X→M、M→Y、X→Y 三条路径上的关键混淆变量应加以控制,否则 a、b、c′ 都会受到污染。
- 样本量:Bootstrap 需要足够样本支撑重抽样,一般建议 ≥ 200。
何时用 · 何时不该用
- 用:需要回答"X 为什么影响 Y"——解释机制、厘清传导链。
- 别用:只想预测 Y、不关心原因;或数据为横截面却要下强因果结论。
常见误区
路径分解:c = c′ + ab 是恒等式
单中介模型由两个回归方程定义(\(\varepsilon_M \perp X\)、\(\varepsilon_Y \perp (X, M)\)):
分解定理(Alwin & Hauser, 1975):把方程 1 代入方程 2 再与总效应方程对比系数——
对应系数相等即得 \(c = c' + ab\)——这是恒等式而非近似,只要线性可加模型设定正确就精确成立(样本中因估计误差两边略有出入)。「完全中介」= \(c' = 0\)、「部分中介」= \(c' \neq 0\) 只描述直接效应大小;中介是否存在只看 间接效应 ab 的显著性。
ab 的抽样分布:为什么是偏态的
\(\hat{a}\)、\(\hat{b}\) 各自近似正态,但两个独立正态变量的乘积不服从正态分布(正态乘积分布,Craig, 1936)——它是偏态的、尾部更厚。\(a\)、\(b\) 都远离 0 时乘积近似正态;\(a\) 或 \(b\) 接近 0 时严重偏离正态、集中在 0 附近——而「效应很小」恰是中介检验最常见的场景。
Sobel (1982) 用 Delta 方法(一阶泰勒展开)近似 \(g(a,b) = ab\) 的方差:
三个公式都假设 \(\hat{a}\hat{b}\) 近似正态——这在边界附近不成立,导致 Sobel 高估 p 值、漏判间接效应。变体只是对 SE 的轻微修正,本质缺陷未变。
Bootstrap CI:不假设分布的替代
算法(Efron & Tibshirani, 1993):① 从原始数据有放回抽 \(n\) 个样本;② 在该 Bootstrap 样本上重估 \(\hat{a}_k^{*}\)、\(\hat{b}_k^{*}\) 得乘积;③ 重复 \(K\) 次(常规 \(K = 5000\));④ 将所得 \(\{\hat{a}_k^{*} \hat{b}_k^{*}\}\) 排序取分位作 CI——直接从样本模拟抽样分布,不假设参数形式。
| 方法 | 一类错误率 | 检验力 | 计算成本 |
|---|---|---|---|
| Sobel | 偏保守 | 低 | 极低 |
| Percentile Bootstrap | 略偏保守 | 高 | 中 |
| BC Bootstrap | 接近名义水平 | 最高 | 中 |
| BCa Bootstrap | 接近名义水平 | 最高 | 高 |
MacKinnon 等 (2004) 的 Monte Carlo 对比:多数场景用 percentile 或 BC、5000 次重抽样即可;BCa 仅在极端偏态时略优。
反事实框架:NDE、NIE 与敏感性分析
对每个个体定义潜在结果:\(Y_i(x, m)\)(X 强制为 \(x\)、M 强制为 \(m\) 时的 Y)、\(M_i(x)\)(X 强制为 \(x\) 时的 M)、\(Y_i(x, M_i(x'))\)(跨版本反事实)。Pearl (2001) 的分解——
基本分解定理 \(TE = NDE + NIE\) 恒成立。关键定理(Pearl, 2001;Imai 等, 2010):线性可加、无交互模型下 \(NDE = c'\)、\(NIE = ab\)——两套框架完全一致;有交互项 \(\theta XM\) 时 \(NIE = a(b+\theta)\)、\(NDE = c' + \theta E[M(0)]\),分解仍成立但不再等于 \(c'\)、\(ab\)。
因果解释需要 Sequential Ignorability 两个假设:① \(\{Y_i(x,m), M_i(x)\} \perp X_i \mid \mathbf{C}_i\);② \(Y_i(x,m) \perp M_i \mid X_i, \mathbf{C}_i\)。②「M 无未测混淆」不可检验。敏感性分析设 \(\rho = \mathrm{Corr}(\varepsilon_M, \varepsilon_Y)\) 衡量未测混淆强度:微小的 \(\rho\) 就能翻转结论 → 因果推断脆弱;很大的 \(\rho\) 才翻转 → 结论稳健。
多重中介、有调节中介与测量误差
并行中介:多个 \(M_j\) 各自传导,特定间接效应 \(a_j b_j\),总间接效应 \(IE_{total} = \sum_j a_j b_j\),总效应 \(c = c' + \sum_j a_j b_j\)。注意 \(b_j\) 是控制其他所有 \(M_l\) 后的效应——\(M\) 间高度相关时各 \(b_j\) 不稳定。
串行中介 \(X \to M_1 \to M_2 \to Y\):三条间接路径——
有调节中介:W 调节 a 路径时条件间接效应 \(IE(W=w) = (a_1 + a_3 w) \cdot b\),索引测试(Hayes, 2015)\(\mathrm{Index} = a_3 \cdot b\)——Index 的 Bootstrap CI 不含 0 即「中介效应被 W 调节」;W 同时调节 a 与 b 时 \(IE(w) = (a_1 + a_3 w)(b_1 + b_3 w)\) 是 \(w\) 的二次函数。
测量误差双重压低:\(M\) 有测量误差时 \(\hat{b} \xrightarrow{p} b \cdot \rho_{MM}\)(\(\rho_{MM}\) 为信度),\(X\) 有误差时类似压低 \(a\),联合效应——
信度均为 0.8 时 \(ab\) 被低估到真值的 64%——「用总分做中介易低估」的根源,信度低时应改用 SEM 潜变量中介。
9结构方程模型(SEM)
同时估计多条路径 + 潜变量 —— 将测量误差与结构关系一并估计
潜变量与路径:为什么需要 SEM
中介讲的是单条机制链、用的是观测变量;当需要同时估计多条路径、且变量本身无法直接观测时,便用到 SEM——它是中介的"升级版"。许多研究关心的概念无法直接测量——"自我效能""动机""学业表现"都是抽象构念,只能用几个题目近似。普通回归将题目分数直接相加当作真值,相当于假定测量无误差,这会压低或扭曲路径系数。
SEM 做两件事,一并估计:
- 测量模型:用几个观测指标(方框)定义一个潜变量(椭圆),估计其载荷 λ,将测量误差显式剥离。
- 结构模型:在潜变量之间估计路径(如 ξ → η 的 γ,下图即 自我效能 → 学业表现),相当于"无测量误差的回归"。
椭圆与方框的形态对比是核心视觉语言:椭圆=不可直接观测的潜变量,方框=可观测的量表题项。下图里 ξ=自我效能、η=学业表现为两个潜变量,各挂 3 个真实题项作指标,λ 是题项对潜变量的载荷,γ 是自我效能对学业表现的结构路径。拖 λ 看测量质量如何决定拟合,拖 γ 看路径强弱——注意 γ 无法改善拟合,拟合好坏取决于测量。
- 拟合指标报全套:χ²(df, p)、CFI、TLI、RMSEA(含 90% CI)、SRMR——只挑 CFI 一项达标就写"拟合良好"是审稿大忌;不达标项如实呈现并讨论。
- 测量模型先于结构模型:先报载荷表(含显著性),再报结构路径系数——载荷弱时先修测量,结构解释放在拟合可接受的前提下。
- 措辞规范——写"模型与数据拟合可接受",不写"模型得到验证"(拟合好 ≠ 唯一正确,等价模型可能同样好);模型修正(MI)若做,需说明理论依据并在独立样本交叉验证。
- 路径图(sem_path_diagram.png)——AMOS 风格:椭圆/圆角框 = 潜变量、方框 = 观测指标,单箭头 = 回归路径(结构路径 b、测量载荷),箭头上数字 = 标准化系数;观测框角标的 SMC = 该指标被潜变量解释的比例(载荷²)。画布底部一行拟合指数速览。
- 载荷热图(sem_loading_heatmap.png)——指标 × 潜变量载荷矩阵:看每列是否"一列独高"(指标只在自己因子上高载荷 = 区分效度好);绝对值 <0.4 的弱载荷格需要留意。
- R² 条形图(sem_r2_bar.png)——每个内生潜变量被模型解释的方差比例;结构模型的核心故事(如"干预强度解释了干预满意度 45% 的方差")。
- 拟合指数条形图(sem_fit_indices.png)——CFI/TLI/RMSEA/SRMR 对照判断阈值着色(绿=达标、橙=边缘):先看整体拟合再解读路径,拟合差时路径系数解释意义有限。
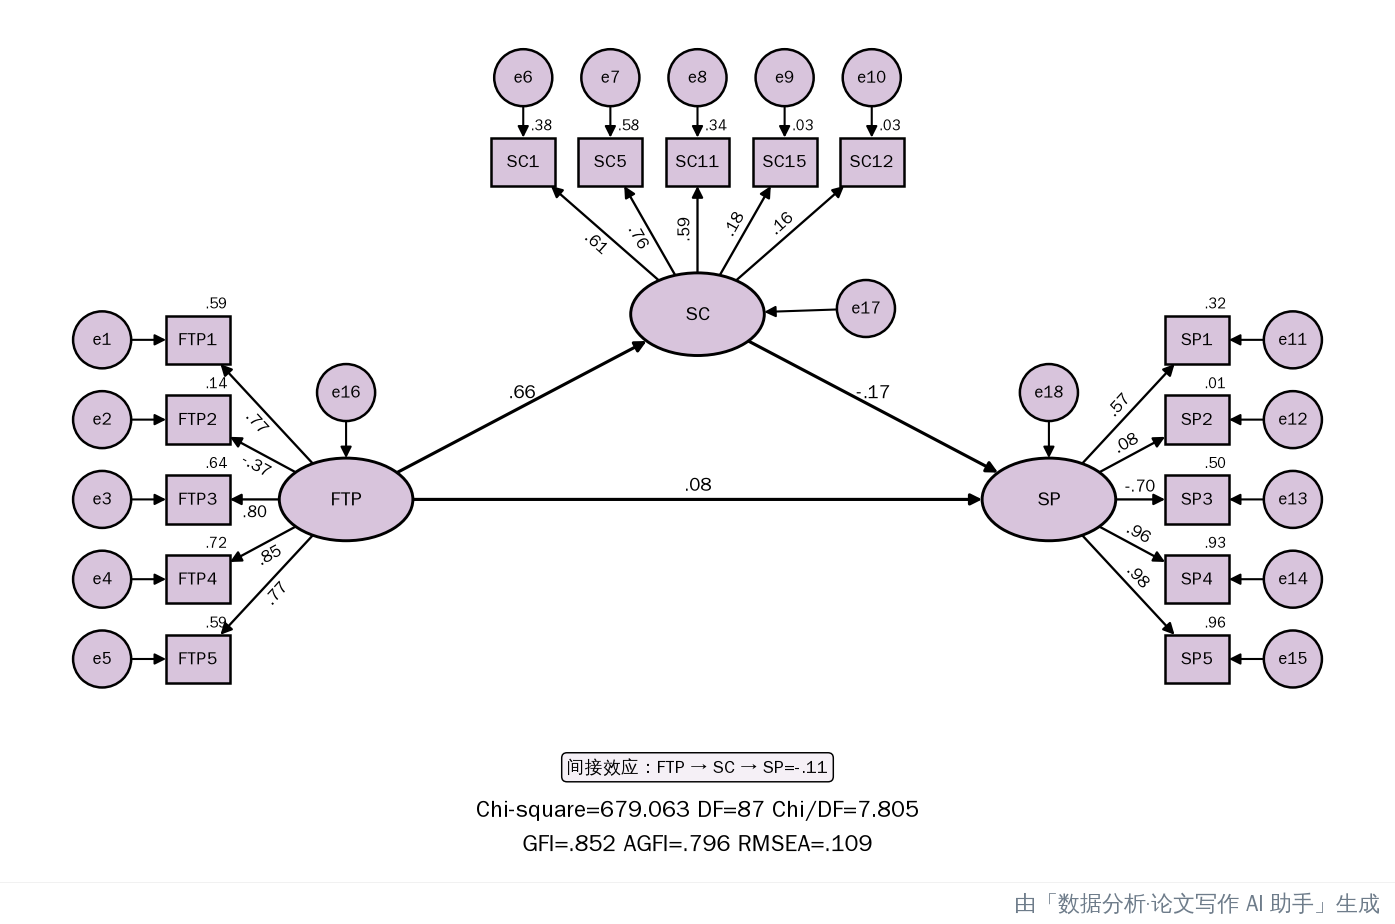
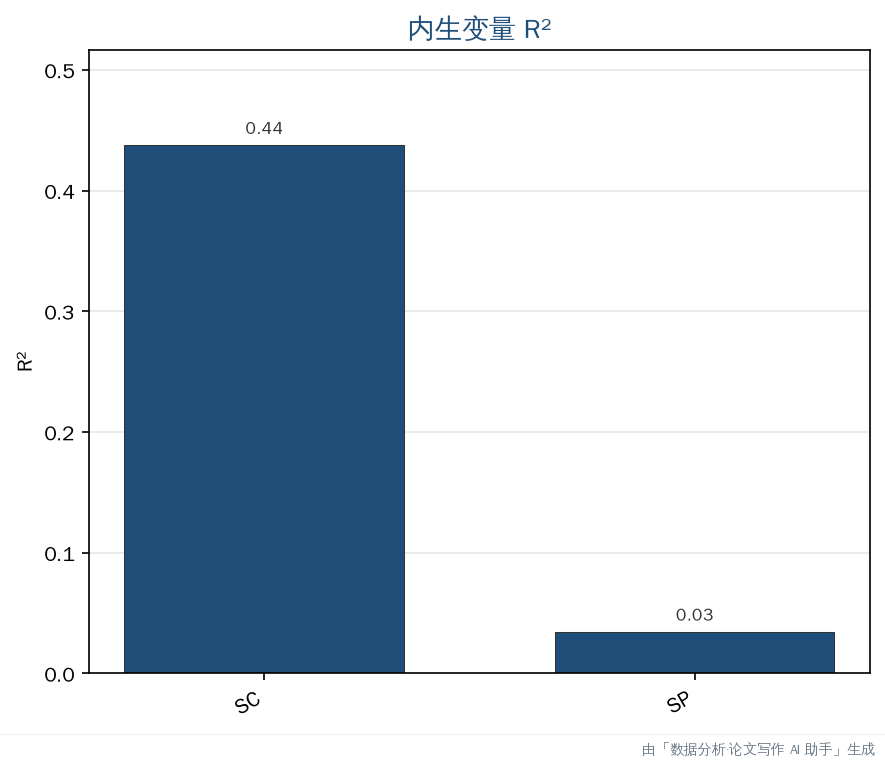
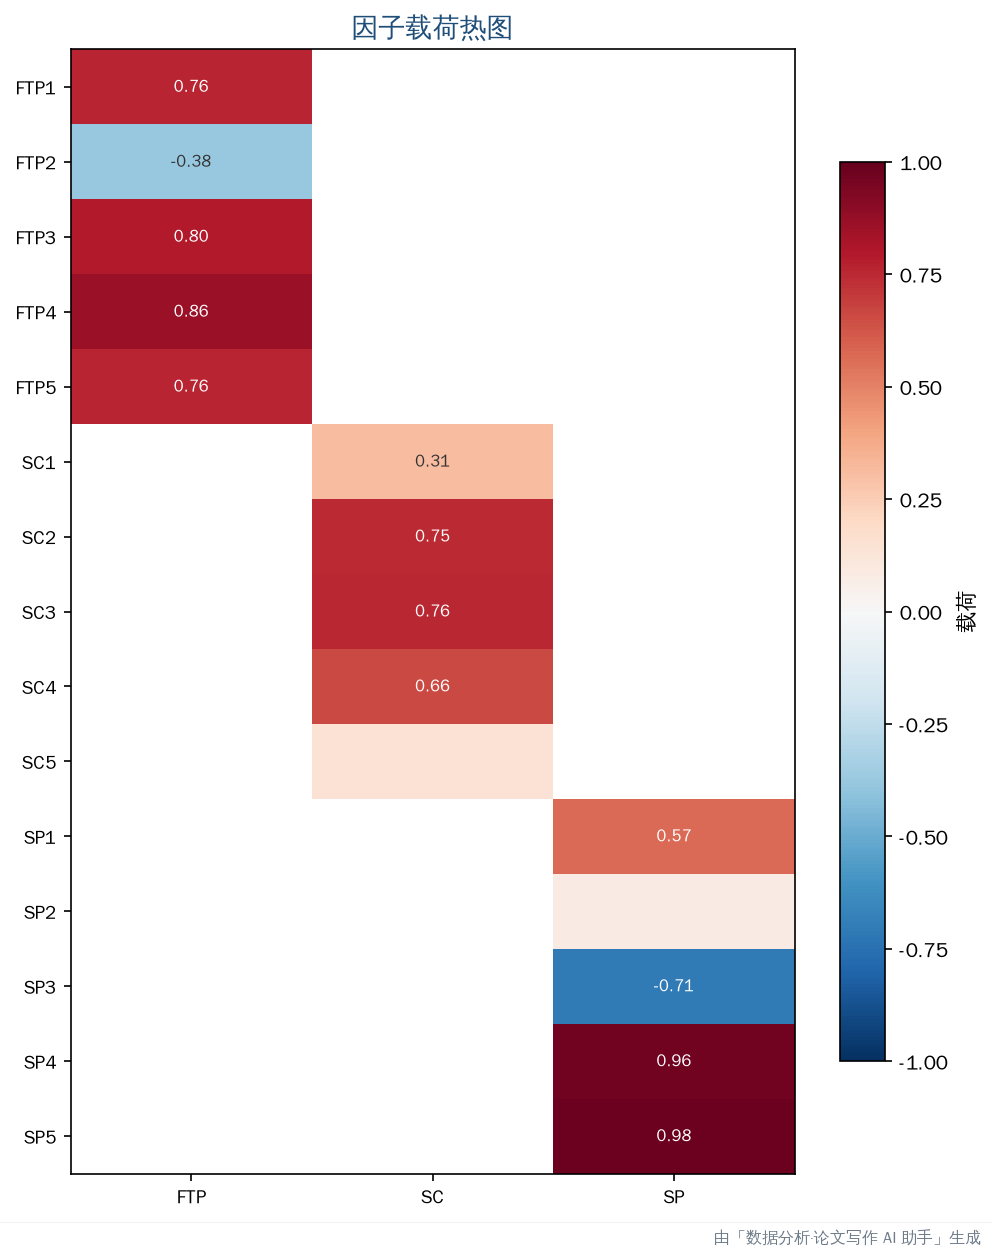
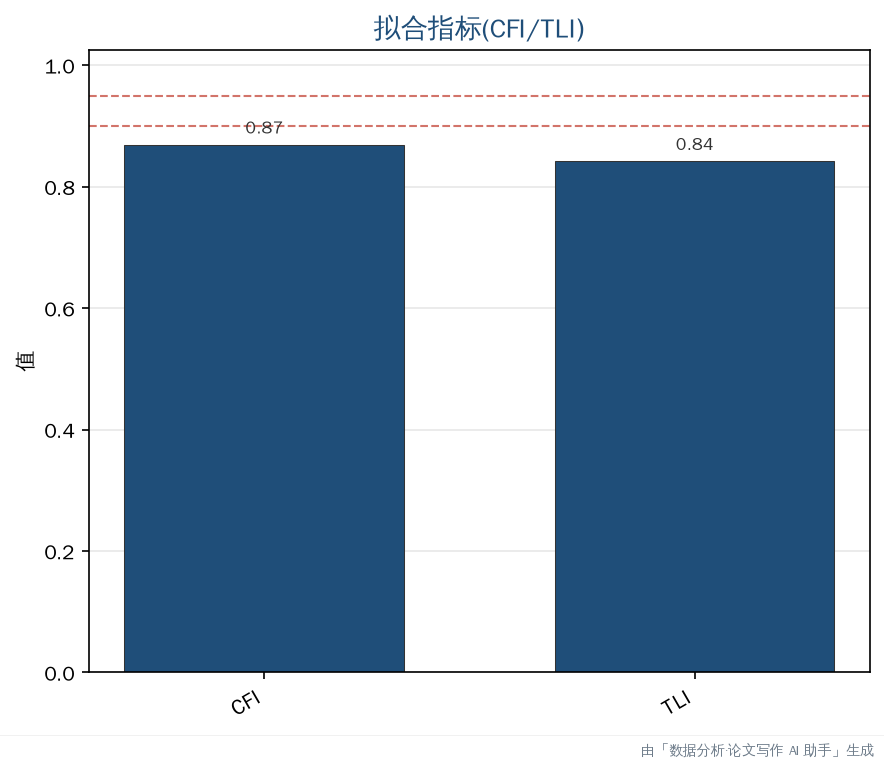
↑ 以上截图均由「数据分析·论文写作 AI 助手」对真实调查数据(护理专业学生样本,n=573)自动分析生成 · 带自己的数据去跑一遍 →
拟合指标:模型和数据吻合到什么程度
SEM 不像回归只有一个 R²,它给出一组拟合指标,从不同角度衡量"模型隐含的协方差结构"与"实际数据的协方差结构"差异多少。常用判据:
单一指标不足以定论。应看一组指标的综合:CFI/TLI 达 0.90、RMSEA/SRMR 在 0.08 以下,才算"拟合可接受"。上图拖 λ 时,CFI 和 RMSEA 随测量质量变化(载荷越高、题项越能反映潜变量、拟合越好),两条线同时达标才亮绿灯;γ 只改变路径粗细与解释比例,不影响拟合——这正是 SEM 的关键:拟合取决于测量模型,路径强弱是另一回事。
前提假设
- 样本量充足:指标数 × 10 以上是粗略下限,复杂模型要更多。
- 正态或稳健估计:ML 估计假设多元正态;偏态较重时宜用稳健 ML(MLR)或更换估计法。
- 模型可识别:待估参数不能比数据能提供的信息多,否则无解。每个潜变量至少要有 3 个指标才稳。
- 理论驱动:模型设定应有理论依据,不宜靠数据倒推出一个拟合好的结构。
何时用 · 何时不该用
- 用:研究里有潜变量(抽象构念用多指标测量)+ 多条结构路径同时检验。
- 别用:所有变量均为单题观测、路径简单——此时路径分析或普通回归即可,上 SEM 属过度建模。
常见误区
LISREL 全模型:两类变量、三组方程
Jöreskog (1970) 的 LISREL 框架把变量分成潜变量(\(\eta\) 内生、\(\xi\) 外生——不可直接观测的构念)与观测变量(\(y\) 内生指标、\(x\) 外生指标——量表题目),完整模型由三组方程构成:
还需指定四个协方差矩阵:\(\boldsymbol{\Phi}\)(\(\xi\) 间协方差)、\(\boldsymbol{\Psi}\)(\(\zeta\) 的协方差)、\(\boldsymbol{\Theta}_{\delta}\)、\(\boldsymbol{\Theta}_{\varepsilon}\)(测量误差,通常对角)。参数向量 \(\boldsymbol{\theta} = \mathrm{vech}(\boldsymbol{\Lambda}_x, \boldsymbol{\Lambda}_y, \mathbf{B}, \boldsymbol{\Gamma}, \boldsymbol{\Phi}, \boldsymbol{\Psi}, \boldsymbol{\Theta}_{\delta}, \boldsymbol{\Theta}_{\varepsilon})\) 包含全部待估量。
家族关系:多元回归(全观测、无测量模型)、路径分析(无测量模型)、CFA(只有测量模型)、MIMIC、中介、CLPM——全部是 LISREL 全模型的特殊情形。SEM 是这一大家族的统一框架。
模型隐含协方差矩阵 Σ(θ):核心恒等式
SEM 的核心思想:样本协方差矩阵 \(\mathbf{S}\) 与模型隐含协方差矩阵 \(\boldsymbol{\Sigma}(\boldsymbol{\theta})\) 匹配得越好,模型越合理。从结构方程解出 \(\boldsymbol{\eta}\)(要求 \(\mathbf{I} - \mathbf{B}\) 可逆)——
这就是模型的核心恒等式——把参数 \(\boldsymbol{\theta}\) 映射到观测变量的协方差结构。一因子 CFA 例:3 个指标时样本协方差 \(\mathbf{S}\) 提供 \(\binom{3}{2}+3 = 6\) 个矩条件,模型却有 \((3+3+1 = 7)\) 个参数——不可识别,必须加一个约束(固定 \(\lambda_1 = 1\) 或 \(\phi = 1\))。
可识别性:t-rule 与三指标规则
可识别性:参数能否从 \(\boldsymbol{\Sigma}(\boldsymbol{\theta})\) 唯一确定——\(\boldsymbol{\Sigma}(\boldsymbol{\theta}_1) = \boldsymbol{\Sigma}(\boldsymbol{\theta}_2) \Rightarrow \boldsymbol{\theta}_1 = \boldsymbol{\theta}_2\)。若不可识别,同一协方差对应多个参数解,估计不唯一。
尺度设定(潜变量方差单位未定):方法 1 参照指标——固定某载荷 \(\lambda_j = 1\)(Mplus / lavaan 默认);方法 2 方差标准化——固定 \(\phi = 1\)。两种方法数学等价:参数一一对应、拟合指标完全一致。
四种估计方法:从 ML 到 DWLS
| 数据类型 | 估计方法 |
|---|---|
| 连续 + 近似正态 | ML |
| 连续 + 非正态 | MLR(Yuan-Bentler 稳健 ML,SE 修正) |
| Likert 5 点及以上 | 视为连续,用 MLR |
| Likert 4 点及以下 / 二分类 | DWLS (WLSMV) |
ML 的性质:渐近无偏、渐近正态、渐近有效;数据非正态时 \(\hat{\theta}\) 仍无偏但 SE 与 \(\chi^2\) 失真——这正是 MLR 存在的理由。
拟合指标的数学:阈值从哪来
阈值来源:Hu & Bentler (1999) 的 Monte Carlo 建议——CFI ≥ .95(严格)/ .90(宽松)、RMSEA ≤ .06(严格)/ .08(宽松)、SRMR ≤ .08。阈值是模拟出来的经验惯例,不是数学定理;\(\chi^2\) 随 \(n\) 线性增长、大样本必然显著,故看一组指标而非单一 \(\chi^2\)。
等价模型:同一组数据常有多个结构不同但拟合几乎一样的模型——拟合达标只说明「模型与数据不矛盾」。MI 滥用:按修改指数逐条加路径能把 CFI「刷」到达标,但这是数据驱动的过拟合,约 60% 的 MI 驱动的修改不可复现,每条改动都应有理论依据。
10交叉滞后(Cross-Lagged)
纵向两时间点,比较 X→Y 与 Y→X 谁更强 —— 推断时间方向性
横截面分不清谁先谁后:为什么需要交叉滞后
横截面数据(单一时间点)中,例如屏幕使用时间和抑郁症状存在相关,难以判断是屏幕推高抑郁、抑郁让人更多刷屏、还是第三变量(睡眠、压力)同时驱动两者——时间信息缺失。交叉滞后用至少两个时间点的面板数据来处理这一难题:在控制各自的自回归稳定性(屏幕₁→屏幕₂、抑郁₁→抑郁₂)之后,比较两条"交叉路径"——屏幕₁→抑郁₂ 和 抑郁₁→屏幕₂——谁更强、谁显著,据此推断谁在时间上领先。
其最大价值并非证明因果,而是给出时间方向——排除"其实是反过来"的反向解释:横截面相关分不清屏幕推高抑郁、还是抑郁让人更多刷屏,交叉滞后能提示谁在时间上领先,这是横截面相关无法给出的(因果三要素:关联/时序/非虚假,它补上"时序"一项,但仍无法解决"非虚假"——未测量的混淆变量仍可能同时影响两边)。比横截面相关更近一步,但尚未达到因果。
直观理解
下图上排是 T1(学期初)的屏幕使用、抑郁症状,下排是 T2(学期末)的同一对变量。灰色虚线是同期相关,灰实线是自回归稳定性。两条彩色主路径即交叉项:拖 屏幕₁→抑郁₂ 系数 axy 和 抑郁₁→屏幕₂ 系数 ayx,看哪条更粗更显著 → 谁在时间上领先。箭头粗细=路径强弱,绿色=正向、红色=负向。两条都弱→无方向证据;一强一弱→方向较明确;两条相当→双向。
Y₂ = β₁Y₁ + γ₁X₁ + e
X₂ = β₂X₁ + γ₂Y₁ + e
β=自回归(稳自身)、γ=交叉路径(跨时间影响);比 γ 定方向性。
- 四条路径全报:两条自回归(含不显著的也要报,它们是控制项)+ 两条交叉滞后(系数/SE/p/CI),外加 Wave 1 同期相关——只报显著的交叉路径会被质疑选择性报告。
- 措辞规范——交叉滞后显著写"X₁ 预测了 Y₂ 的变化",不写"X 影响 Y":CLPM 提供的是纵向预测方向证据,不是因果证明。
- limitations 必须交代——CLPM 无法分离个体间与个体内效应(Hamaker et al. 2015),更严格的设计是 RI-CLPM;未测时变混淆仍可能驱动结果。
- 交叉滞后路径图(clpm_path_diagram.png)——顶部 T1→T2 时间轴;水平箭头 = 自回归(X₁→X₂、Y₁→Y₂,变量自身的稳定性),斜向箭头 = 交叉滞后(X₁→Y₂、Y₁→X₂,跨时间预测),左侧双箭头弧 = Wave 1 同期相关。实线显著、虚线不显著,系数为标准化 β。读法:两条交叉滞后都显著 → 双向互惠;只有一条显著 → 单向主导;都不显著 → 无跨时间预测。
- 路径系数条形图(clpm_coef_bar.png)——蓝 = 自回归(稳定性),橙 = 交叉滞后(互惠预测),灰 = 不显著。两条橙条的长短对比直接回答"哪个方向预测力更强";自回归通常明显更长(变量自己预测自己最稳),属正常。
- 组间差异图(clpm_group_diff.png,分组分析时)——每组路径的 β₂−β₁ 差值,p 值着色;显著 = 该路径的预测强度在两组间不同。
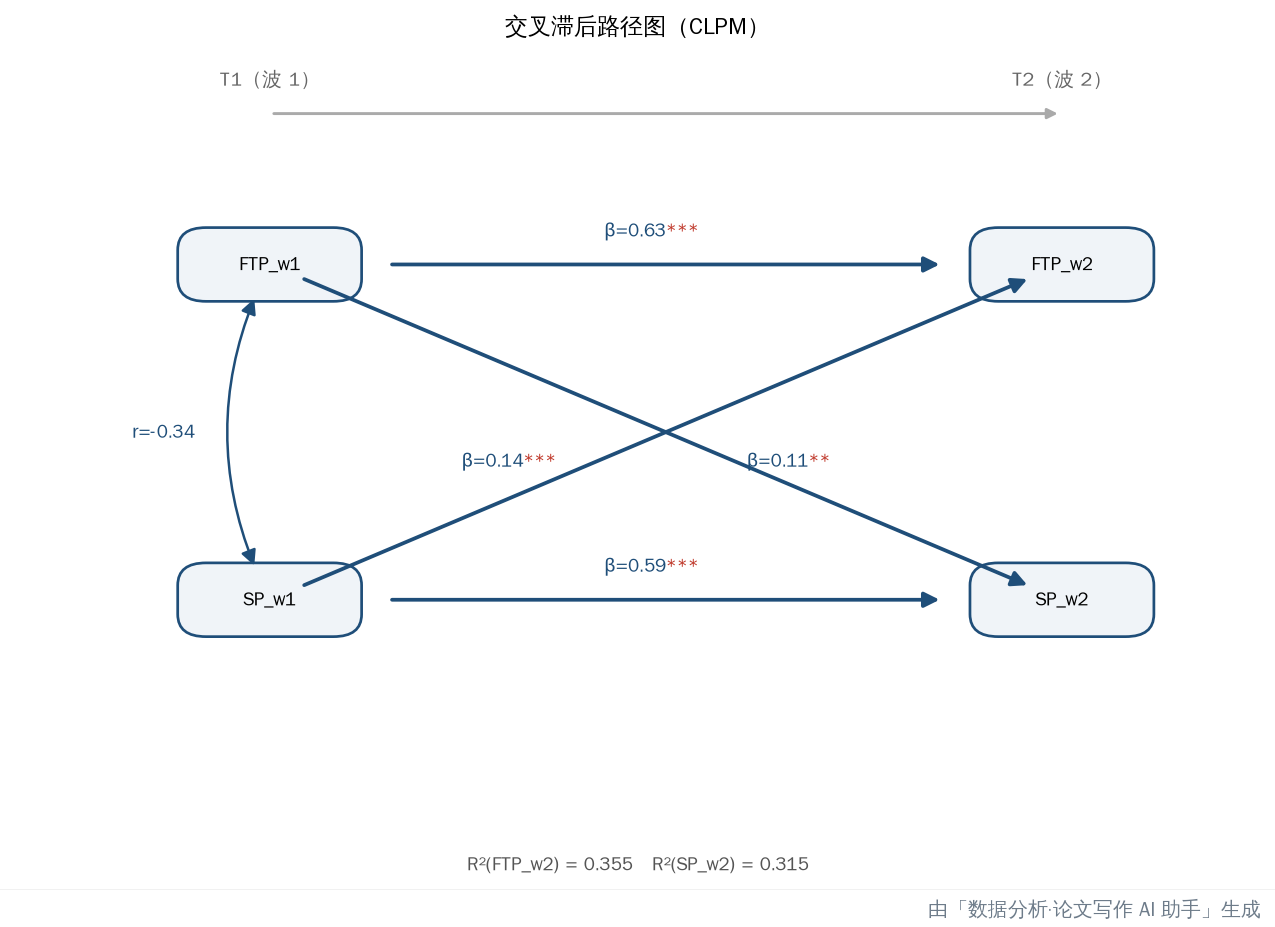
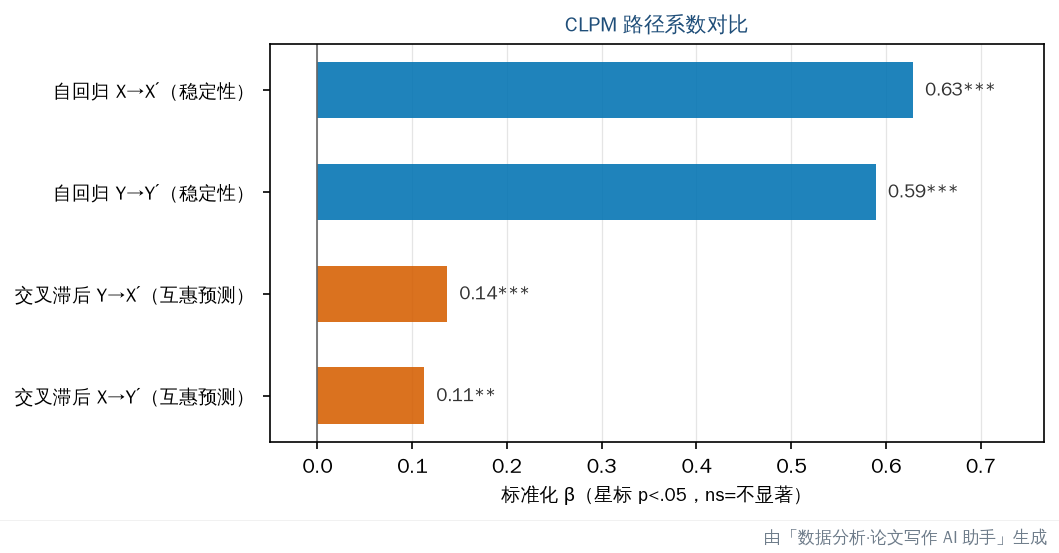
↑ 以上截图均由「数据分析·论文写作 AI 助手」对真实调查数据(护理专业学生样本,n=573)自动分析生成 · 带自己的数据去跑一遍 →
交叉路径与方向性
关键在于"控制了自回归之后":交叉路径衡量的是对方在 T1 的状态能额外预测本变量在 T2 的变化多少。a 显著强于 b → 提示屏幕领先抑郁;反之同理;两条相当 → 双向影响;都不显著 → 看不出时间方向(可能是同期关系或混淆驱动)。
前提假设
- 纵向面板:至少两个时间点,同一批人重复测量。单点横截面得不出方向。
- 时间间隔合理:太短效应来不及显现(看似同期),太长中间过程已被消化或混入新扰动。
- 测量等值性:跨时点量表度量不变,否则变化是测量漂移而非真变化。
- 样本量充足:面板建模对样本要求高,结构方程/路径模型估计需足够样本。
何时用 · 何时不该用
- 用:有纵向面板数据、想推断 X 与 Y 谁在时间上领先谁(方向性)。
- 别用:仅有横截面(给不出方向);或时间间隔明显不合理;或想要严格因果结论(仍需实验/前测设计)。
常见误区
定义:一对联立回归方程
CLPM 把两个变量、两个时间点写成联立回归方程:每个变量当期的值,由「自己上一期」(自回归)与「对方上一期」(交叉滞后)共同解释——
自回归 \(\phi_{XX}, \phi_{YY}\) 是惯性(同变量跨时间稳定性);交叉滞后 \(\phi_{XY}\)、\(\phi_{YX}\) 才是方向性证据。判读规则:交叉路径显著、且 \(|\phi_{YX}| > |\phi_{XY}|\) 才说 X 时间上领先 Y。两条路径是否相等可做约束检验:拟合「\(\phi_{XY} = \phi_{YX}\)」约束模型,与自由模型比 χ² 差(H₀: \(\phi_{XY} = \phi_{YX}\))。
VAR(1) 视角:向量化的系统动力学
把两个方程并成一个向量方程,就是时间序列里的一阶向量自回归 VAR(1)——
特征值条件保证系统不会发散——每波传递都收缩一点,长期收敛到均衡 \(\boldsymbol{\mu}_\infty\)。稳态方差由 Lyapunov 方程 \(\mathbf{V} = \boldsymbol{\Phi}\mathbf{V}\boldsymbol{\Phi}^\top + \boldsymbol{\Sigma}_\varepsilon\) 给出。注意:两波数据只有 3 个可用的跨期相关,恰好把 4 个 \(\phi\) 系数 + 截距 + 残差协方差估满——模型恰好饱和,任何假设都无法被拒绝,稳定性、均衡等性质全都不可检验。
两大缺陷:混淆与假阳性
缺陷一 · between/within 混淆。观测值被拆成两部分:个体间稳定差异(trait)与个体内波动(state)——
CLPM 直接用 \(X_{it}\) 回归 \(X_{it-1}\),把 trait 的稳定性(between)和真正的状态惯性(within)混在一起。自回归系数高,可能只是「人还是那个人」的稳定差异,与「状态随时间惯性延续」无关。
缺陷二 · 假阳性交叉路径。Hamaker, Kuiper & Grasman (2015) 的 Monte Carlo 证明:当真实模型里完全没有个体内交叉效应时(只有 trait 相关),两波 CLPM 仍会以可观概率给出「显著」交叉路径——因为交叉路径在吸收 trait 相关。这是结构性偏差,不是运气问题。
RI-CLPM:分离 trait 后再比交叉
RI-CLPM(随机截距 CLPM)先把 trait 抽走,让交叉路径只作用在 within 部分。测量模型与结构模型——
交叉路径 \(\phi_{XY}\) 现在解释的是「个体偏离自己常态的波动能否预测对方偏离常态」——这才是 state 层面的方向效应。数学上可证 CLPM 的估计是 within 效应与 trait 相关的加权混合:
权重 \(w_1, w_2\) 由样本的时间结构决定。trait 相关 \(\rho_{\eta_X\eta_Y}\) 越强、混合越偏向它——这就是假阳性的机制。识别条件:至少 3 波才能识别随机截距;Mulder & Hamaker (2021) 建议 3 波起步、4 波更稳(可加残差自回归)。
因果层次与测量等值
交叉滞后属于时序方向证据,离因果还有距离。三种因果语言对照——
| 层次 | 核心问题 | 交叉滞后的位置 |
|---|---|---|
| Granger 预测 | X₁ 是否提升 Y₂ 的预测? | ✔ 正是 CLPM 检验的 |
| Rubin 反事实 | 干预 X 是否改变 Y 的分布? | ✘ 需随机/准实验 |
| Pearl 结构因果 | 结构方程中 do(X=x) 的效应? | ✘ 需无未测混淆 + 时序 |
CLPM 提供 Granger 层次的时序证据;因果主张还需反事实或结构层面的额外假设。
测量等值(measurement invariance)是纵向比较的前提:若量表跨时点「测量结构」漂移,T₁→T₂ 变化可能是测量伪迹。单指标观测模型写成——
等值层级由弱到强:configural(因子结构相同)→ metric(载荷 \(\lambda_j\) 跨时点相等)→ scalar(截距 \(\tau_j\) 也相等)→ strict(残差也相等)。CLPM 至少需 载荷 等值;若个别指标不等,可放宽为 partial scalar invariance(至少两个指标 scalar 等值)再比较。
11潜剖面分析(LPA)
把连续指标里的人分成潜在亚群 —— 谁是哪一类
维度 vs 人:为什么需要潜剖面
因素分析把"维度"分类——几个指标是否归在同一因子下;潜剖面分析(LPA)把"人"分类——样本里同质的个体归为一个潜在剖面(亚群)。当你想知道"这群人能不能分成几种典型类型",而不是"这几个变量归几个因子"时,就用 LPA。比如按压力感、应对方式几个连续指标,把学生分成"低危稳定型""高压内耗型""波动型"几类。
模型假设:每个剖面内部服从正态分布、剖面之间均值不同。各剖面在指标空间里呈现为一簇簇分布,可能重叠。
直观理解
下图把压力感、应对方式两个指标摊成平面,每个点是一个学生,同色点聚成一簇——一簇即一个潜在剖面(学生亚群),椭圆是它的范围。比如低压+积极应对那簇是「低危稳定型」,高压+消极应对那簇是「高压内耗型」。拖 k 看剖面数、拖分离度看几簇分得开不开。分离度大→几簇分开、类界清晰;分离度小→椭圆重叠、颜色混淆、学生归哪一类难以判断,宜审慎确定 k。
- 模型比较全表必须报:各 k 的 LogLik/AIC/BIC/aBIC/Entropy/最小类占比——让读者能复现你的选 k 过程,只报"最终选 k=2"不透明。
- 各剖面报 n(%) 与指标 M(SD) 或 z 值,剖面命名要有数据依据(如 z>0.5 记"高"),不凭主观印象;Entropy 与最小类占比低于经验阈值(0.8 / 5%)时如实注明。
- 措辞规范——剖面是"数据驱动的亚组",不写成"类型人群"(暗示本体论存在);抽样偏差与剖面稳定性(需重复验证/独立样本)写进 limitations。
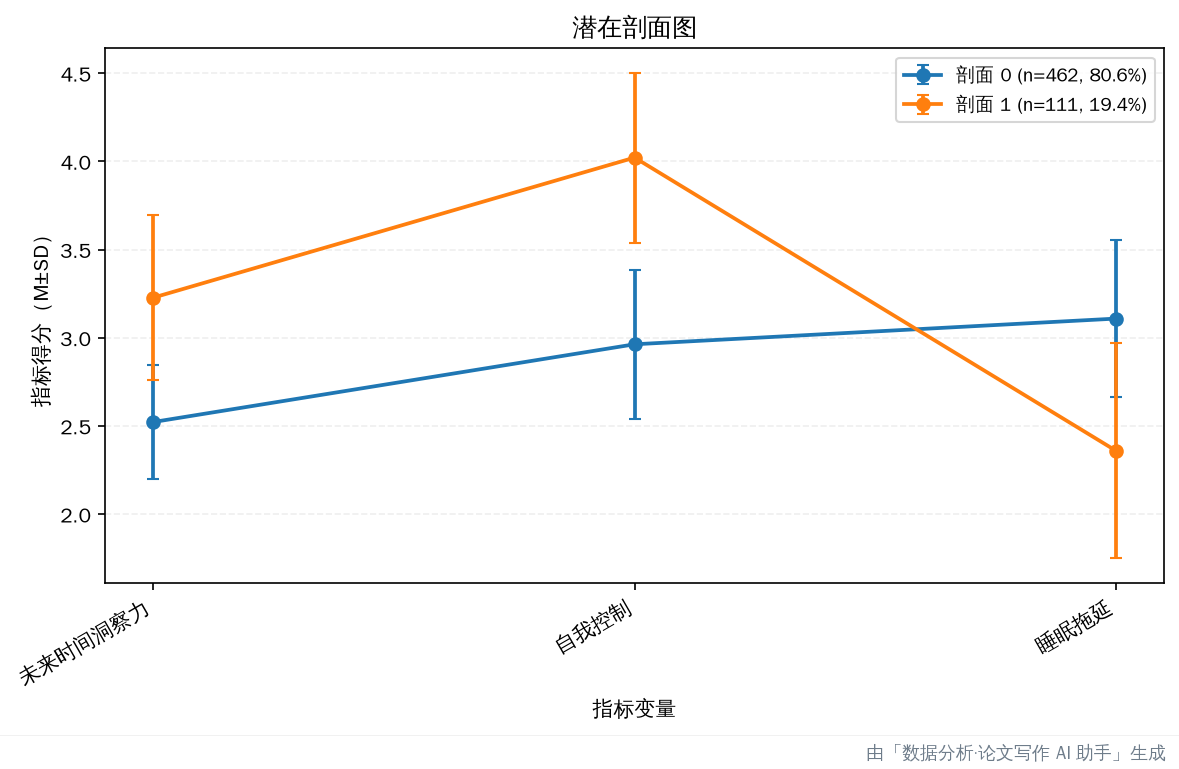
- 剖面图(lpa_profile_plot.png)——每条线 = 一个剖面在各指标上的均值(M±SD 误差条),图例含人数与占比。看线的形状差异区分剖面类型:整体高低不同 = 强度型,形状交错 = 形态型(后者理论上更有价值)。
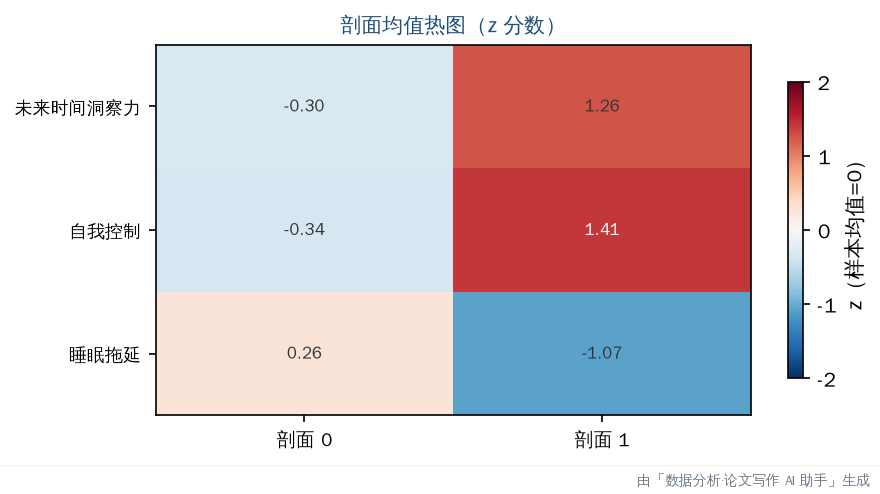
- 剖面均值热图(lpa_profile_heatmap.png)——与剖面图同数据的 z 分数矩阵,红高蓝低(0 = 样本均值)。指标多时比折线图更好读,也是剖面命名的直接依据:每列看一遍高低格局即可命名(如"高自控-低拖延组")。
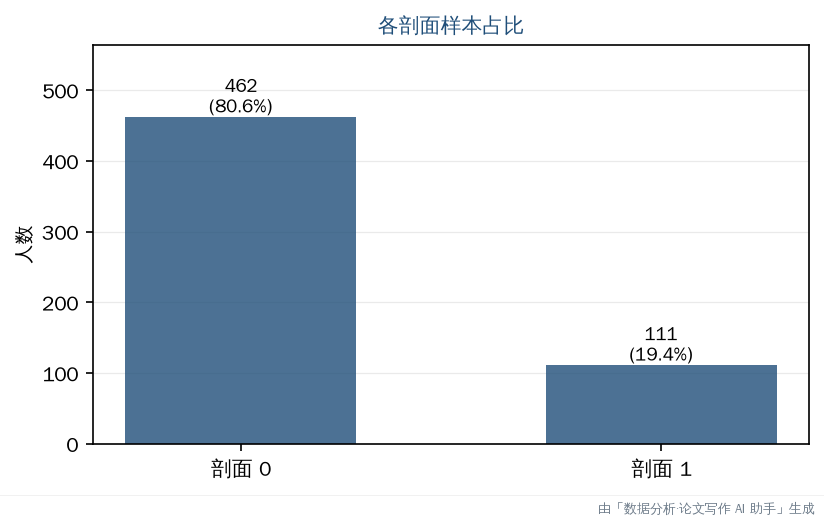
- 剖面占比图(lpa_profile_sizes.png)——人数与占比柱状。最小类占比 <5% 需警惕:样本过少的剖面不稳定、复现性差。
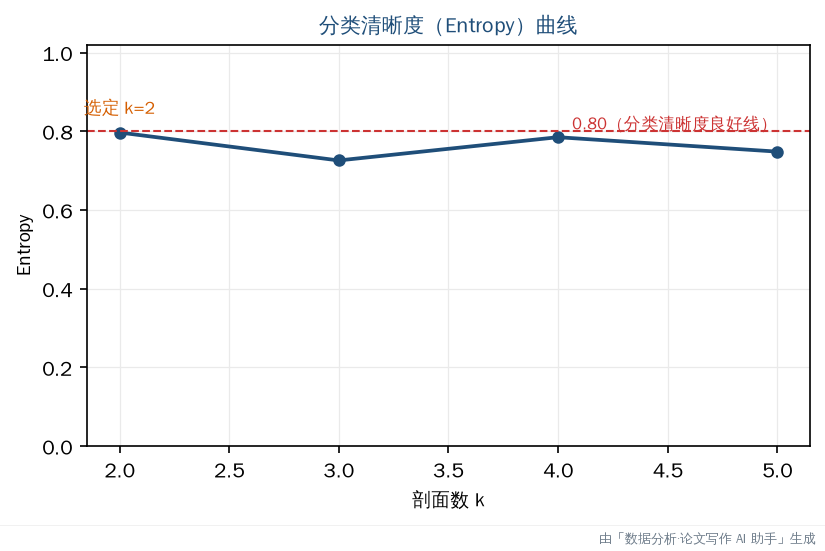
- Entropy 曲线(lpa_entropy_curve.png)——分类清晰度随 k 变化,≥0.80 良好线(红虚线)。k 增大而 Entropy 明显下滑 = 新增剖面可信度存疑,是 BIC 之外的辅助选 k 证据。
- BIC/AIC 曲线(lpa_bic_curve.png)——BIC 拐点(elbow)是选 k 的主要依据;配合上面 Entropy 与最小类占比综合定 k。
↑ 以上截图均由「数据分析·论文写作 AI 助手」对真实调查数据(护理专业学生样本,n=573)自动分析生成 · 带自己的数据去跑一遍 →
模型选择:靠信息指标比 k
定 k 不宜凭主观判断、也不能只看"分几类便于叙述"。主线是信息指标(BIC/AIC)随 k 先降后升取最小,再辅以分类质量指标和剖面在理论上是否可解释。多个判据冲突时,优先选可解释且可重复的解。
前提假设
- 类内多元正态:每个剖面内指标近似正态;严重偏离时考虑非参数变体或转换。
- 局部独立:剖面内指标条件独立(必要时放宽加协方差结构)。
- 足够样本:每个剖面要有足够成员,小样本易过拟合、剖面不可复现。
何时用 · 何时不该用
- 用:想从一组连续指标里发现潜在亚群类型(人是哪一类)。
- 别用:样本小、剖面不可解释;或真实需求是"指标归几个因子"(那是因素分析,分维度不分人)。
常见误区
混合密度:K 个正态的加权和
LPA 是有限混合模型:观测密度 = K 个成分密度的凸组合,\(\pi_k\) 是混合比例(\(\sum_k \pi_k = 1\))——
LPA 假设各类内 协方差结构最简单(类内独立对角),实际参数比满公式少;换掉协方差假设就变成不同模型——
| 模型 | 指标类型 | 协方差/结构 |
|---|---|---|
| LPA | 连续 | 类内独立(对角) |
| LCA | 分类 | 局部独立 |
| GMM | 连续 | 类特定完整协方差 + 类内因子 |
| LTA | 纵向 | 潜类别随时间转移 |
同一混合框架换「成分分布」就得到不同模型——LPA 只是最朴素的一档。
EM 迭代:看不见的类标签
类归属 \(c_i\) 未观测(缺失数据)。写出观测对数似然(对类求和、无法分解)——
Dempster, Laird & Rubin (1977) 证明 EM 每次迭代都单调提升观测似然,收敛到(局部)极大。但似然面非凸,有三个经典陷阱:标签交换(类编号互换、似然不变)、类塌陷(某类只剩几个点)、奇异协方差(某类方差趋近 0、似然发散)。对策:多次随机初始化(\(R = 100\)–\(500\))取似然最大者,并约束类均值排序或混合比例降序以固定标签。
选类数:信息准则与似然比检验
类数 K 不是自由参数,要用模型选择。信息准则在拟合与复杂度间权衡——
BIC 对参数数惩罚随 n 增长,Nylund, Asparouhov & Muthén (2007) 的模拟显示 LPA 中首选 BIC(比 AIC 稳)。判读看拐点:BIC 随 K 增大而下降,从 K 到 K+1 的下降 \(\Delta\text{BIC} < 10\) 视为「不再有实质改进」,取 K。正式检验用 LMR-LRT(Lo-Mendell-Rubin,修正非标准 χ²)与 BLRT(Bootstrap 似然比,生成 B=100 组模拟数据拟合 K−1 与 K 比较),BLRT 精度最高但计算量大。
分类质量:熵、MPP 与协方差代价
归一化熵把所有个体后验的混乱程度折成 0–1 指标——
\(E_K = 1\) 表示所有 \(\gamma_{ik}\) 接近 0/1(归属完全确定)、\(E_K = 0\) 表示全等概率(完全不确定)。阈值 \(E_K \geq 0.8\) 来自 Clark & Muthén (2009) 的 Monte Carlo——熵 ≥ 0.8 时「以类为预测变量」的后续分析偏差可接受;MPP ≥ 0.7(Nagin, 2005)要求每个类平均至少 70% 把握归属。矩阵版 APP 看对角优势:真实属 k 类的个体在各类上的平均后验构成 K×K 矩阵,对角线应接近 1、非对角应接近 0。
协方差结构的价格。K 类、p 指标下参数数:类内独立对角 \((K-1)+Kp+p\);类特定对角 \((K-1)+Kp+Kp\);完整协方差 \((K-1)+Kp+K\cdot p(p+1)/2\)。K=4、p=6 时分别为 33 / 51 / 111——参数越多越易过拟合,样本不足时优先对角。
3-step 下游:别把软分类当硬事实
分完类常要「拿类去回归」。朴素做法把硬分类 \(\hat{c}_i = \arg\max_k \gamma_{ik}\) 当观测变量直接回归——但 \(\gamma_{ik}\) 不是 0/1,分类有不确定性,当作确定值会低估 SE、偏估效应。
| 方法 | 是否考虑分类误差 | 偏差 |
|---|---|---|
| Naive(硬分类直接回归) | 否 | 严重低估 SE |
| BCH(Bolck-Croon-Hagenaars) | 是(误分类矩阵 Q 校正) | 小 |
| R3STEP / DU3STEP(Vermunt) | 是(保留 \(\gamma_{ik}\) 加权) | 最小 |
| 1-step(分类与回归同时建模) | 是 | 无偏但假设更强 |
现代软件(Mplus、tidyLPA)默认支持校正 3-step——用它就对。
标签交换约束:估计时约束 \(\pi_1 \geq \pi_2 \geq \cdots \geq \pi_K\) 或按第一指标均值排序,固定标签便于解释。样本量底线(Tein, Coxe & Cham, 2013):K=2、3 时 n ≥ 500,K ≥ 4 时 n ≥ 1000;类分离度低(均值差/SD ≈ 1)或最小类占比仅 5% 时还需更大。
12网络分析
变量两两偏相关连成网 —— 谁是核心节点、哪几个构成社区
不纳入潜变量,看系统结构:为什么需要网络
前述方法多把变量收进一两个潜变量或一条路径;网络分析换视角——把每个变量当节点、偏相关当边,直接看变量系统的互联结构。它回答的不是"X 影响 Y 多少",而是"这个系统里谁是核心节点(中心性)、哪几个构成社区、谁是连接不同社区的桥节点"。心理症状网络、生理指标网络常用它——比如把抑郁拆成一组症状,看哪个症状是牵动整体的核心枢纽(前面交叉滞后把抑郁当一个总分,这里反过来把它拆开看内部结构)。
直观理解
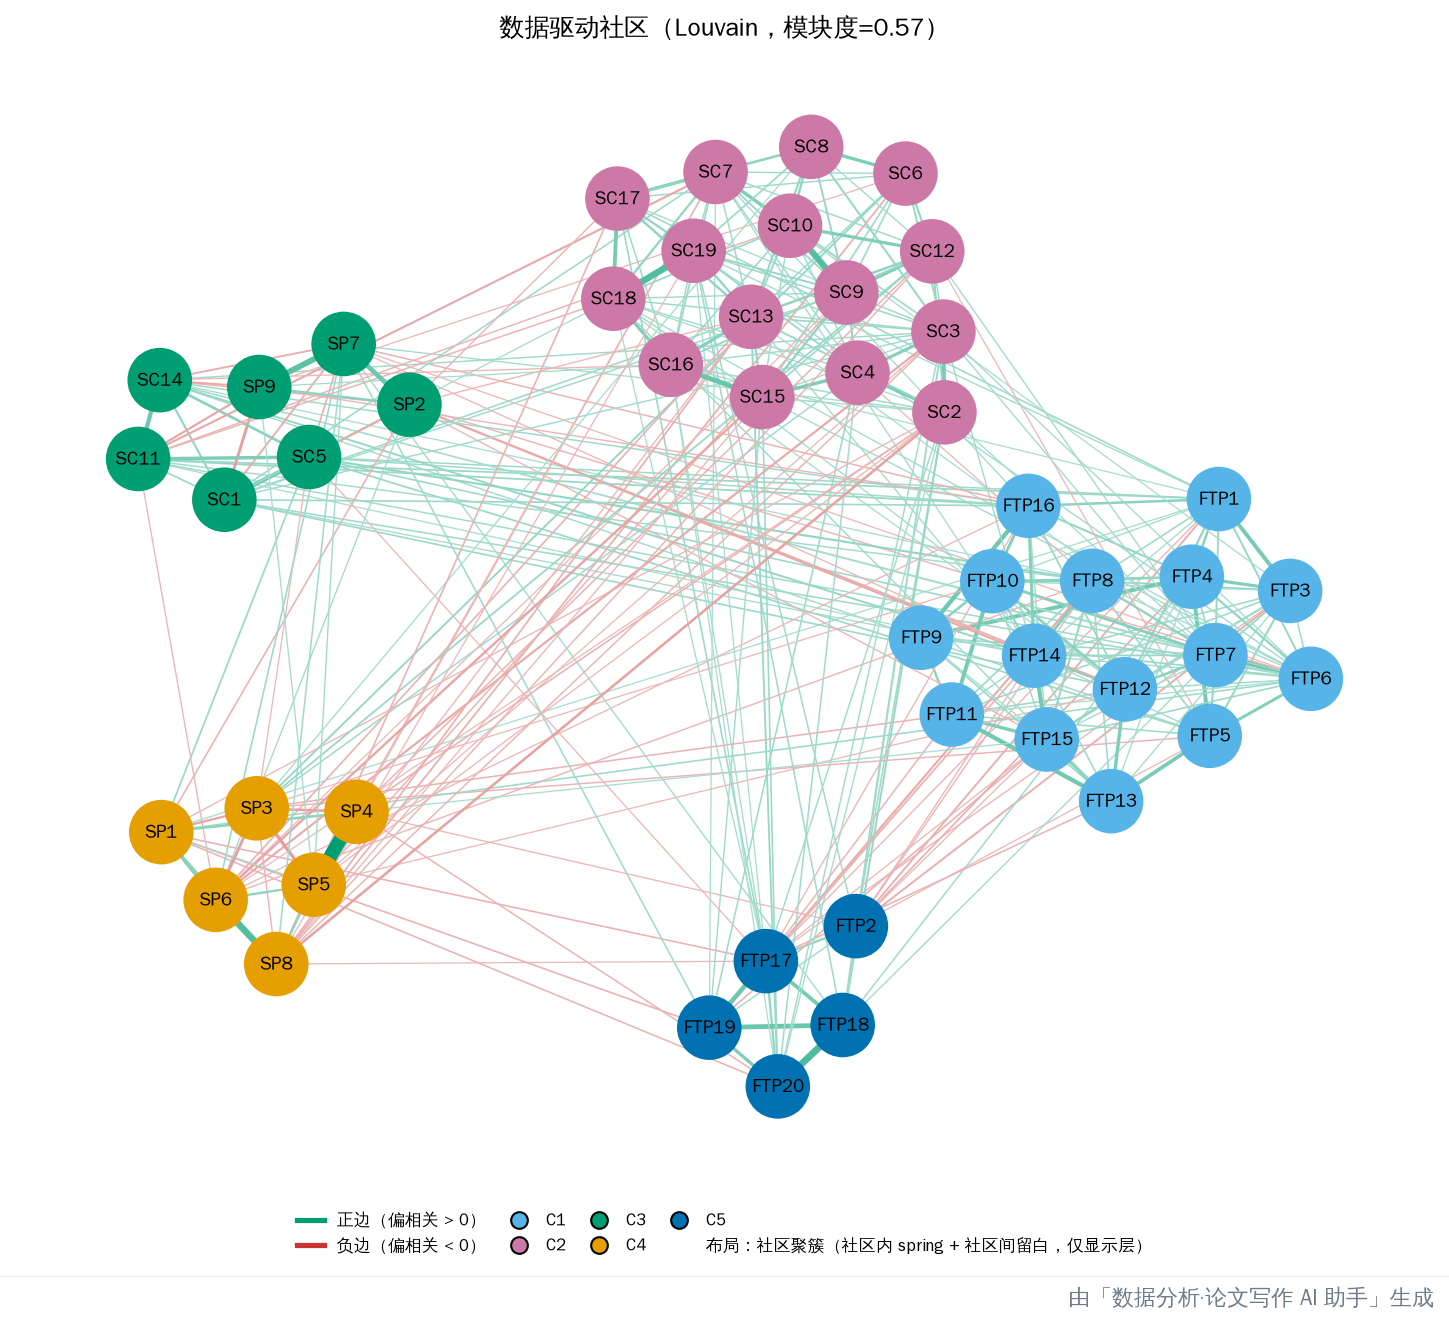
下图把抑郁拆成 6 个症状节点环形排布:情绪低落 / 兴趣丧失 / 自责内疚 / 入睡困难 / 疲倦乏力 / 注意涣散,边=控制其他所有症状后的两两偏相关。同色节点属于一个社区(靛=情绪社区、绿=躯体社区)——社区内症状偏相关强、聚集;社区间只有少数"桥边"连接。拖稀疏度 γ,弱边移除、强边保留——γ=0 时全连接、密集网络分不出社区;γ 适中时两个社区分开、核心症状显现(紫环 + 「核心」标,本例情绪低落,度最高、牵动整体,同时它也是连两个社区的主桥);γ 太高边全部移除、过稀疏无结构。节点越大=度数越高(中心性越强),边越粗=偏相关越强。
- 方法部分必须报齐:估计法与超参数(glasso + EBIC γ=0.5)、节点数与条目、样本量、边数与密度、中心性/桥中心性定义——这些决定结果可复现性,缺一不可。
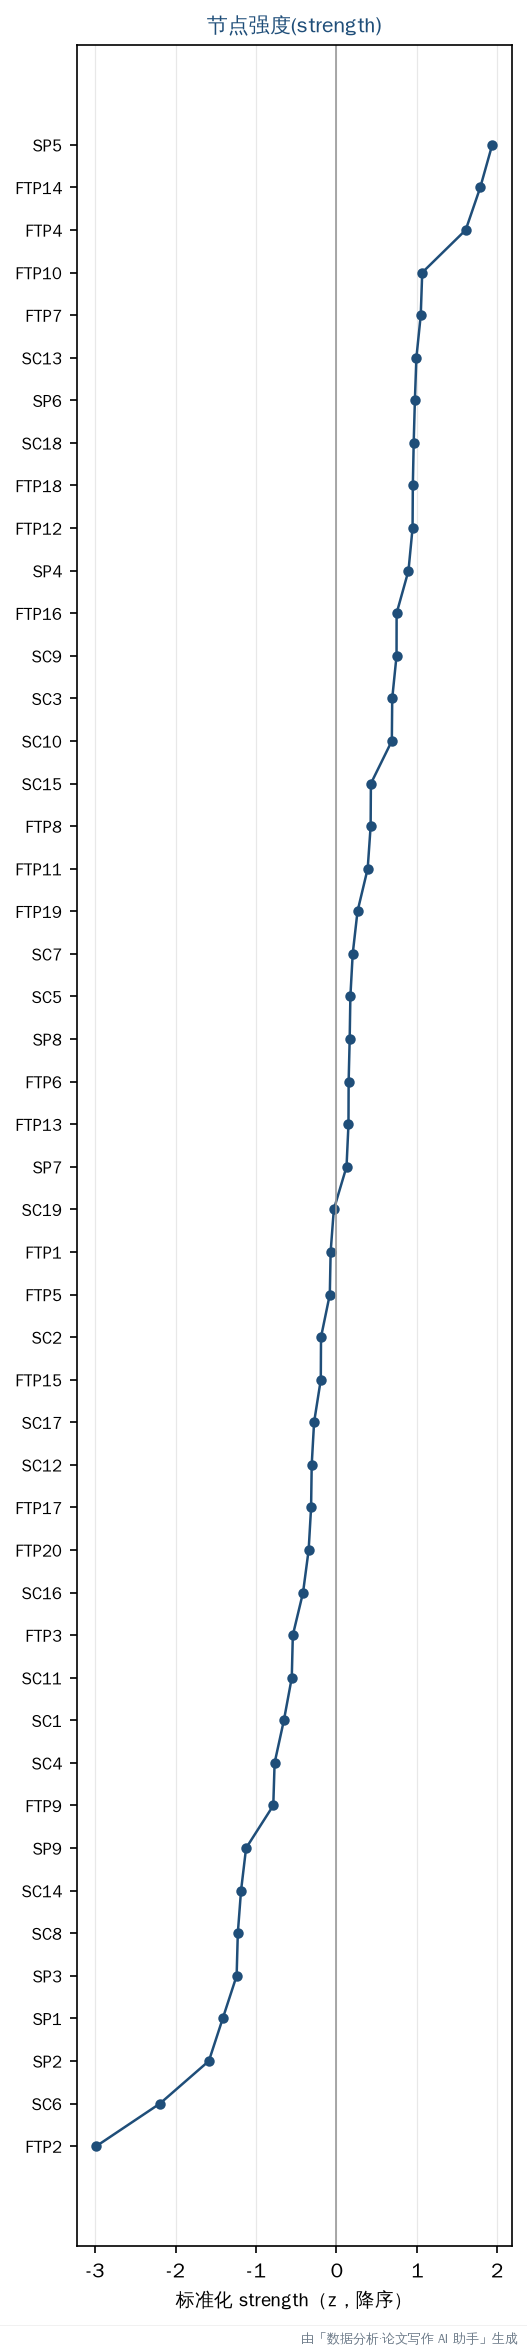
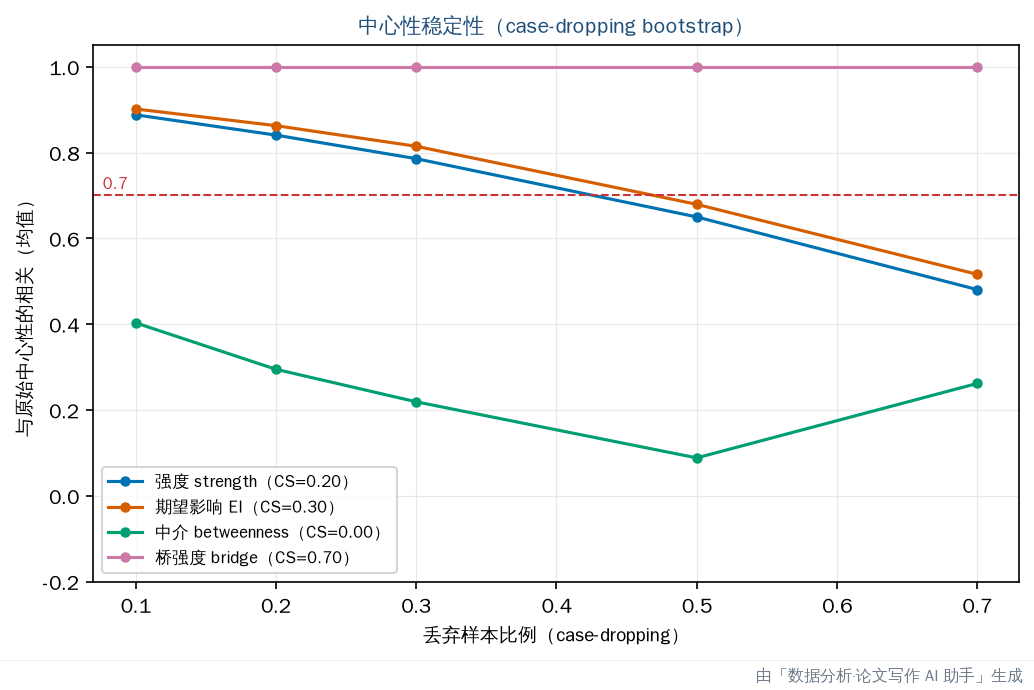
- 中心性解读必须配稳定性:报 CS 系数(case-dropping bootstrap);CS<0.25 时只解释排名最高/最低的节点,中间排名不比高下——没有稳定性支撑的中心性排名等于没报。
- 措辞规范——边是"条件关联",不写"影响/导致";桥节点写"干预研究的候选靶点,需实验验证";γ 敏感性与边稳定性结论写入 robustness 小节。
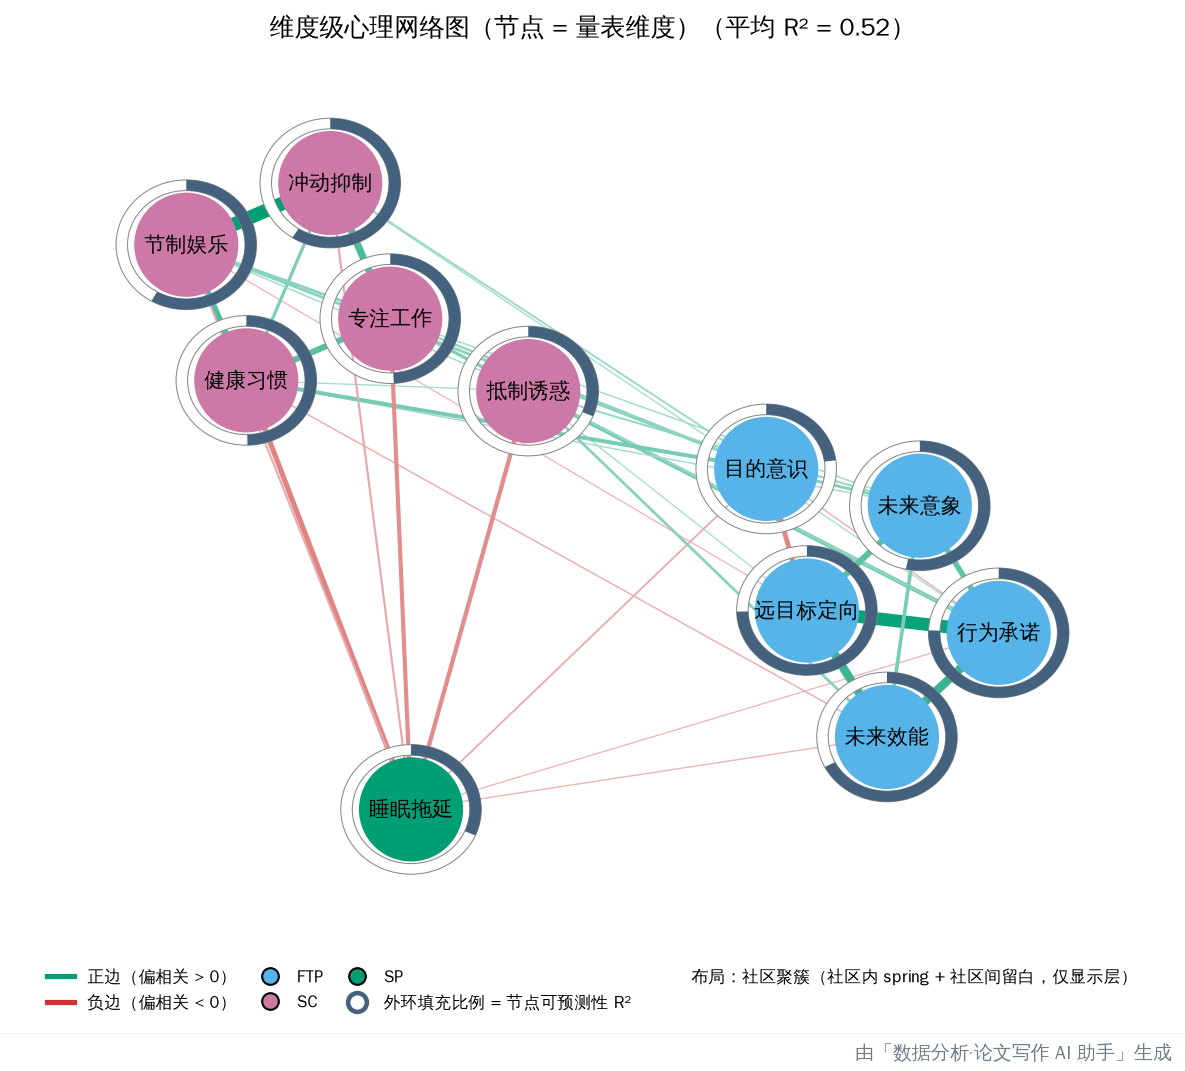
- 全网络图(network_graph.png)——社区聚簇布局:同色聚拢、异色显式留白(社区归属 = 节点颜色 + 图例);绿色边 = 正偏相关、红色边 = 负偏相关,边越粗颜色越饱和 = |权重| 越大;节点外环填充弧 = 可预测性 R²(该节点能被其余节点解释的比例)。作为完备参考基线。
- 强边网络(network_graph_strong.png)——只画 |权重| ≥ 0.1 的边,隐掉弱边噪声看核心连接结构;与全图同布局,逐点可比。
- 桥边网络(network_bridge_graph.png)——只画最强的 20 条跨社区边,节点大小 ∝ 桥中心性:找连接不同量表/社区的桥接点,这是干预切入的候选靶点。
- 边权重热图(network_edge_heatmap.png)——矩阵版:对角块 = 社区内连接,离块亮格 = 桥边;无线条交叉,适合补充材料。
- 中心性排序图(network_centrality_strength / expected_influence / bridge_strength / bridge_ei / predictability.png)——z 标准化降序点线:谁是核心节点、谁是桥节点、谁的 R² 高(可预测性好)。解读须配合稳定性(见下)。
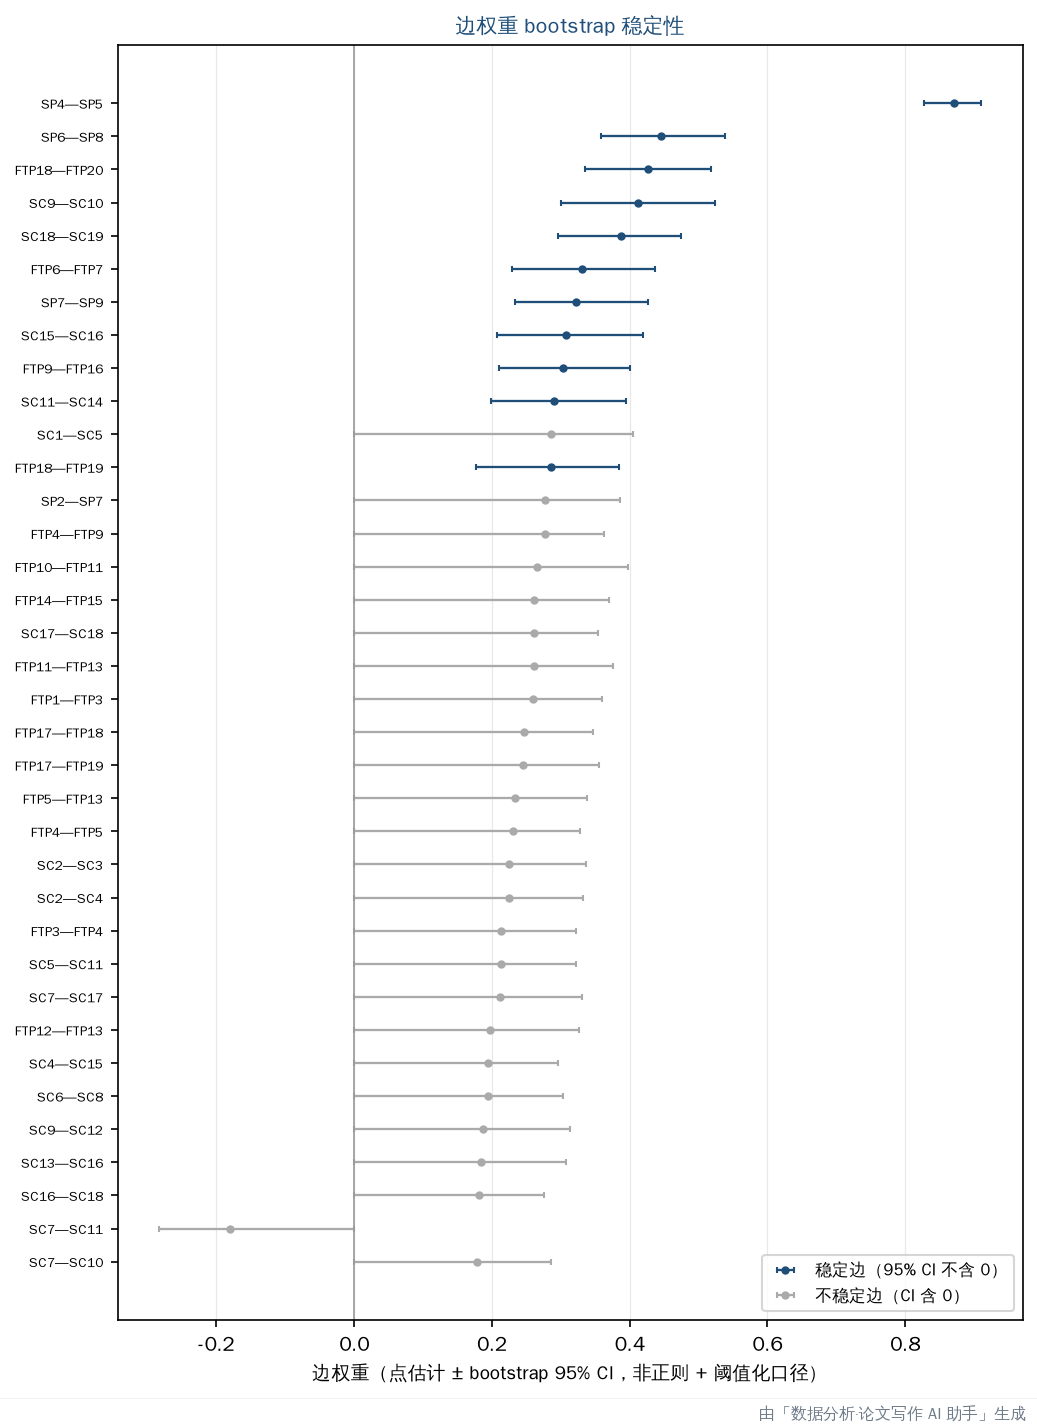
- 稳定性三角——边 CI 图(network_edge_boot_ci.png,实色 = 95% CI 不含 0 的稳定边)、CS 衰减图(network_centrality_stability.png,CS>0.5 佳、<0.25 时中心性排名只信最高/最低者)、差异遮罩图(灰格 = 两节点中心性差异不显著,排名相邻者不可轻分高下)。审稿人问"结果稳不稳"就看这三张。
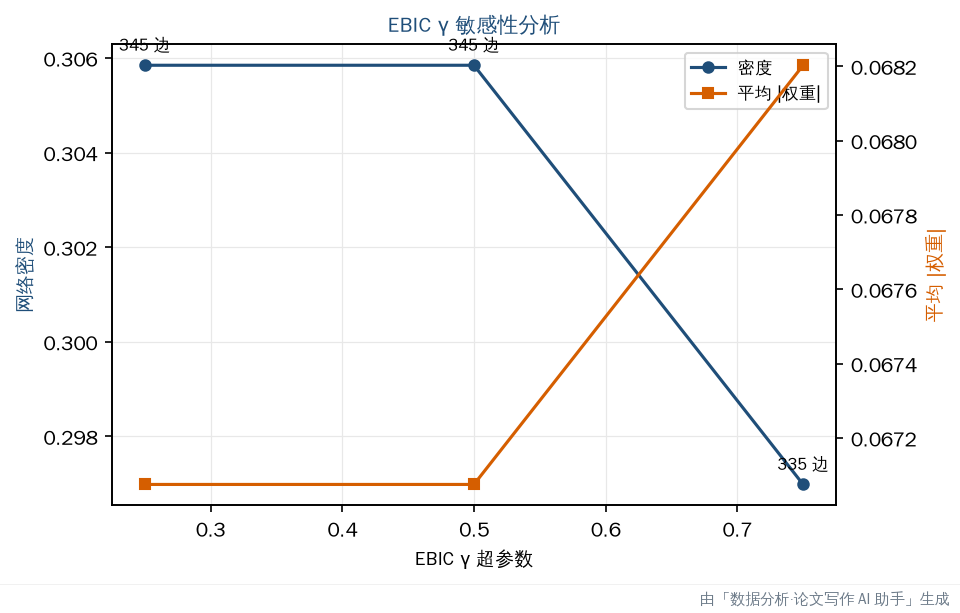
- 稳健性附图——γ 敏感性曲线(结论是否依赖正则化参数)、数据驱动社区 vs 理论社区对比(ARI>0.6 = 量表结构获得网络视角的效度证据)、维度级网络(节点少图干净,适合论文主图)。
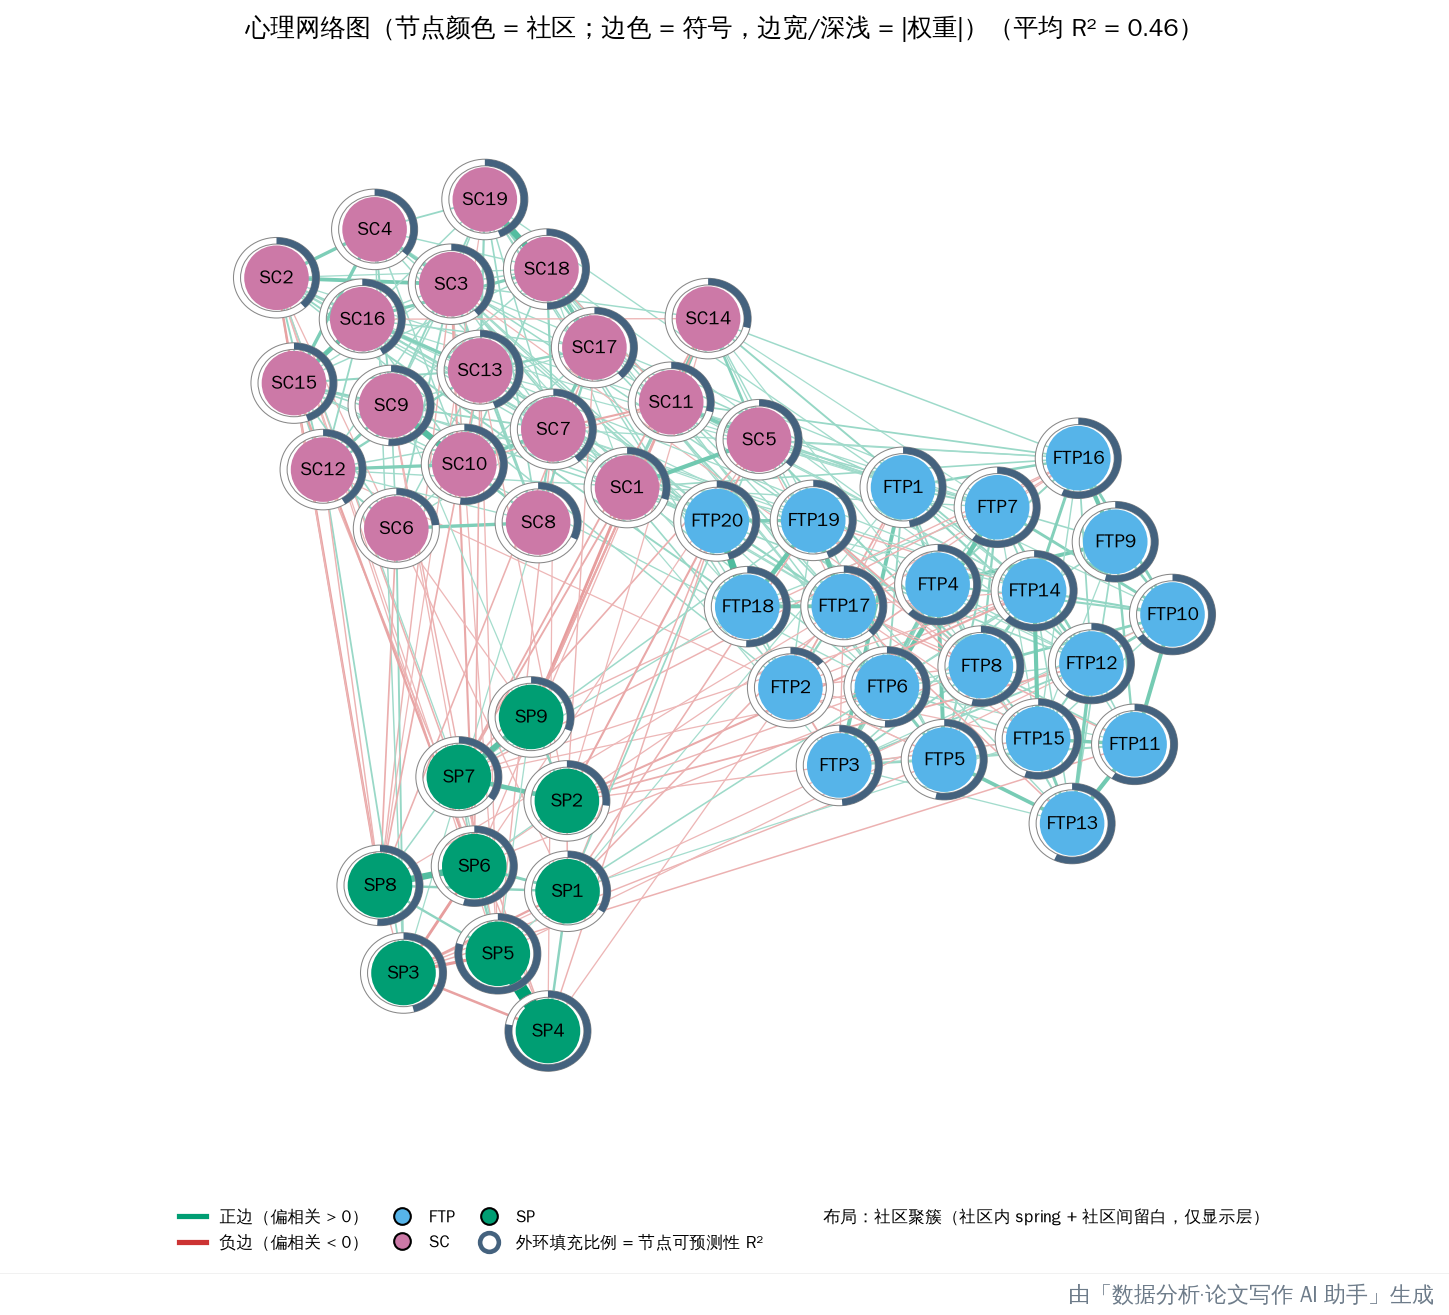
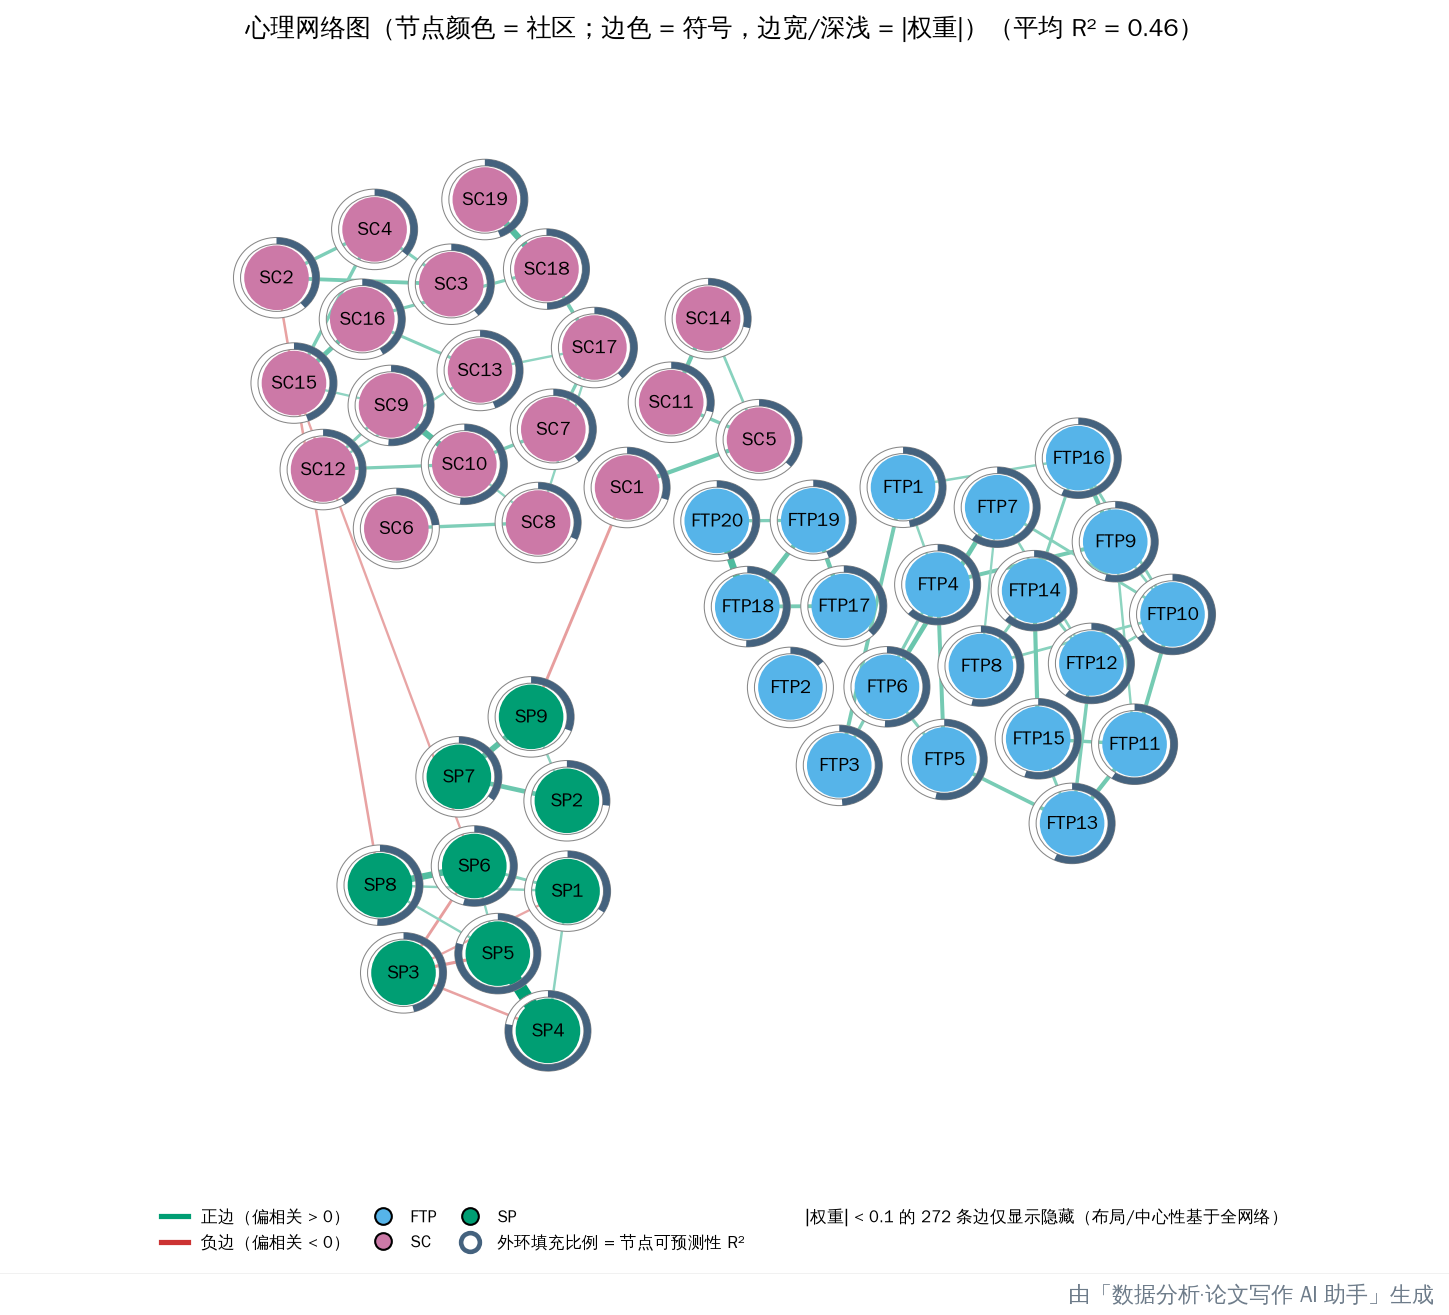
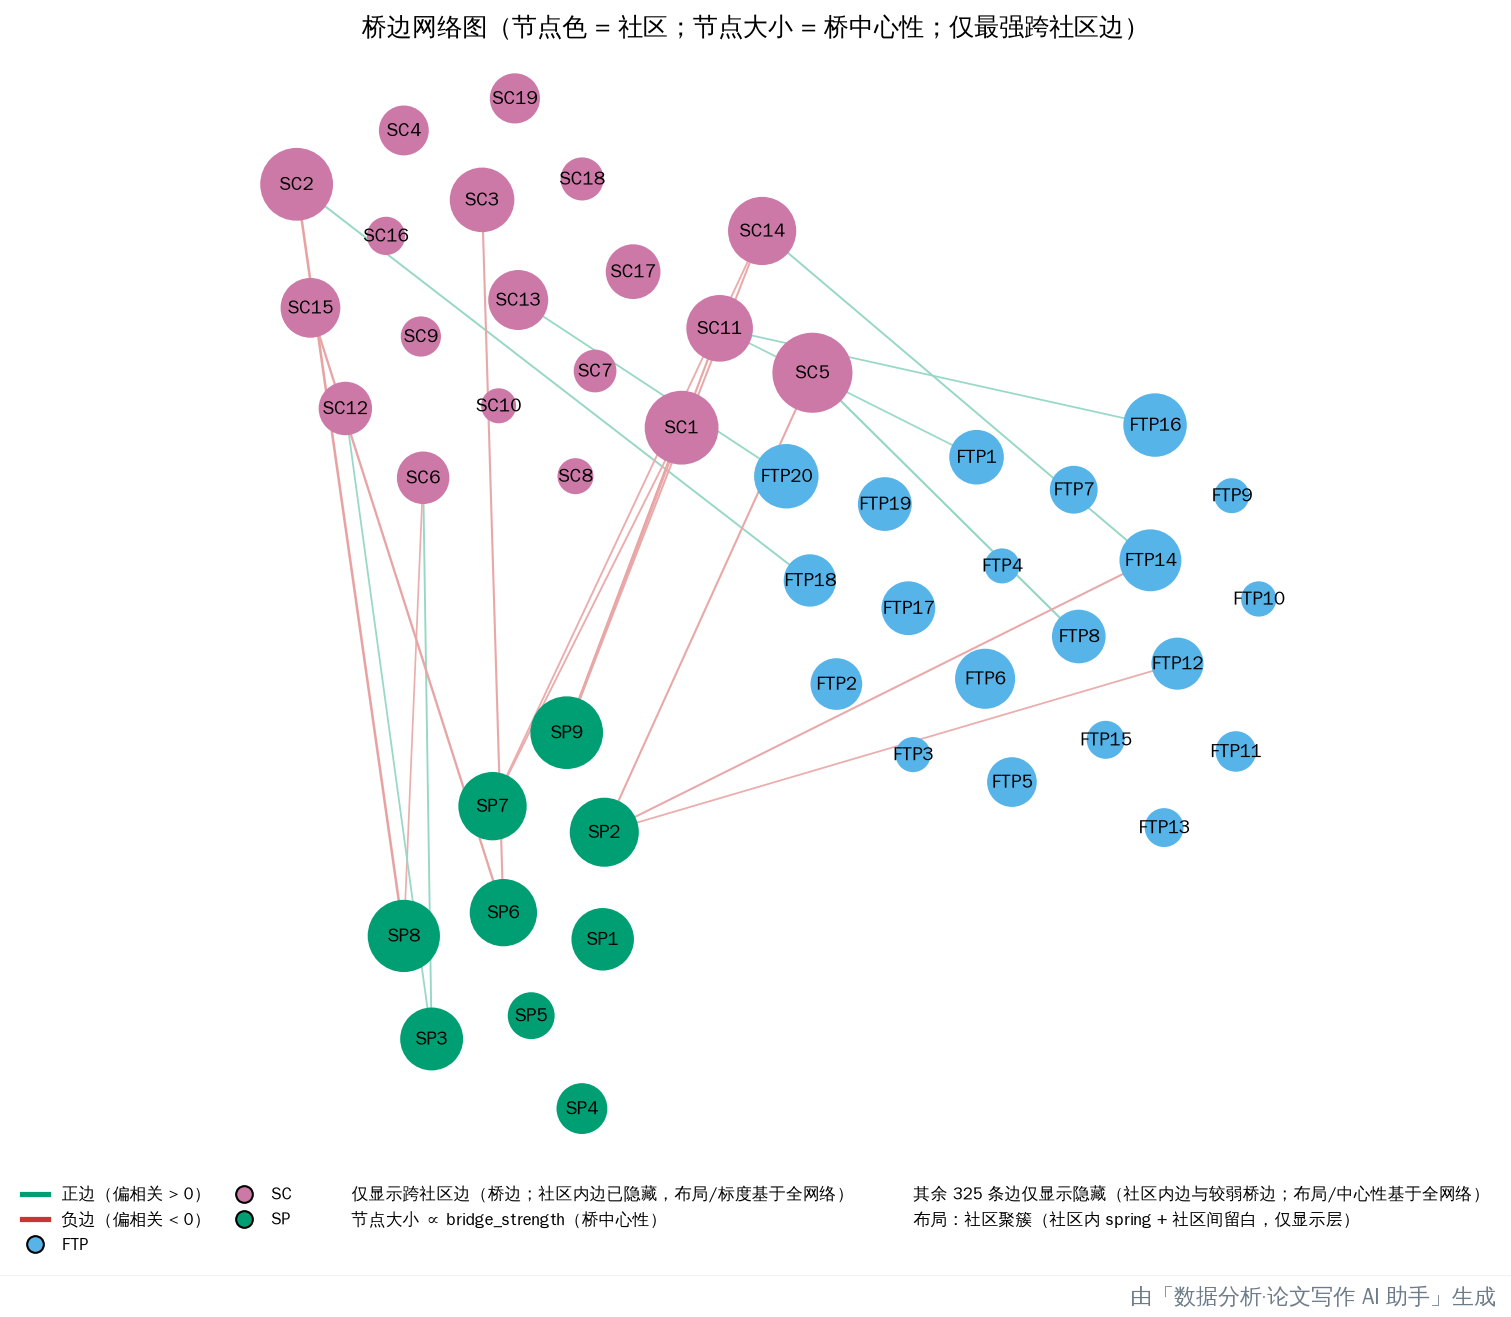
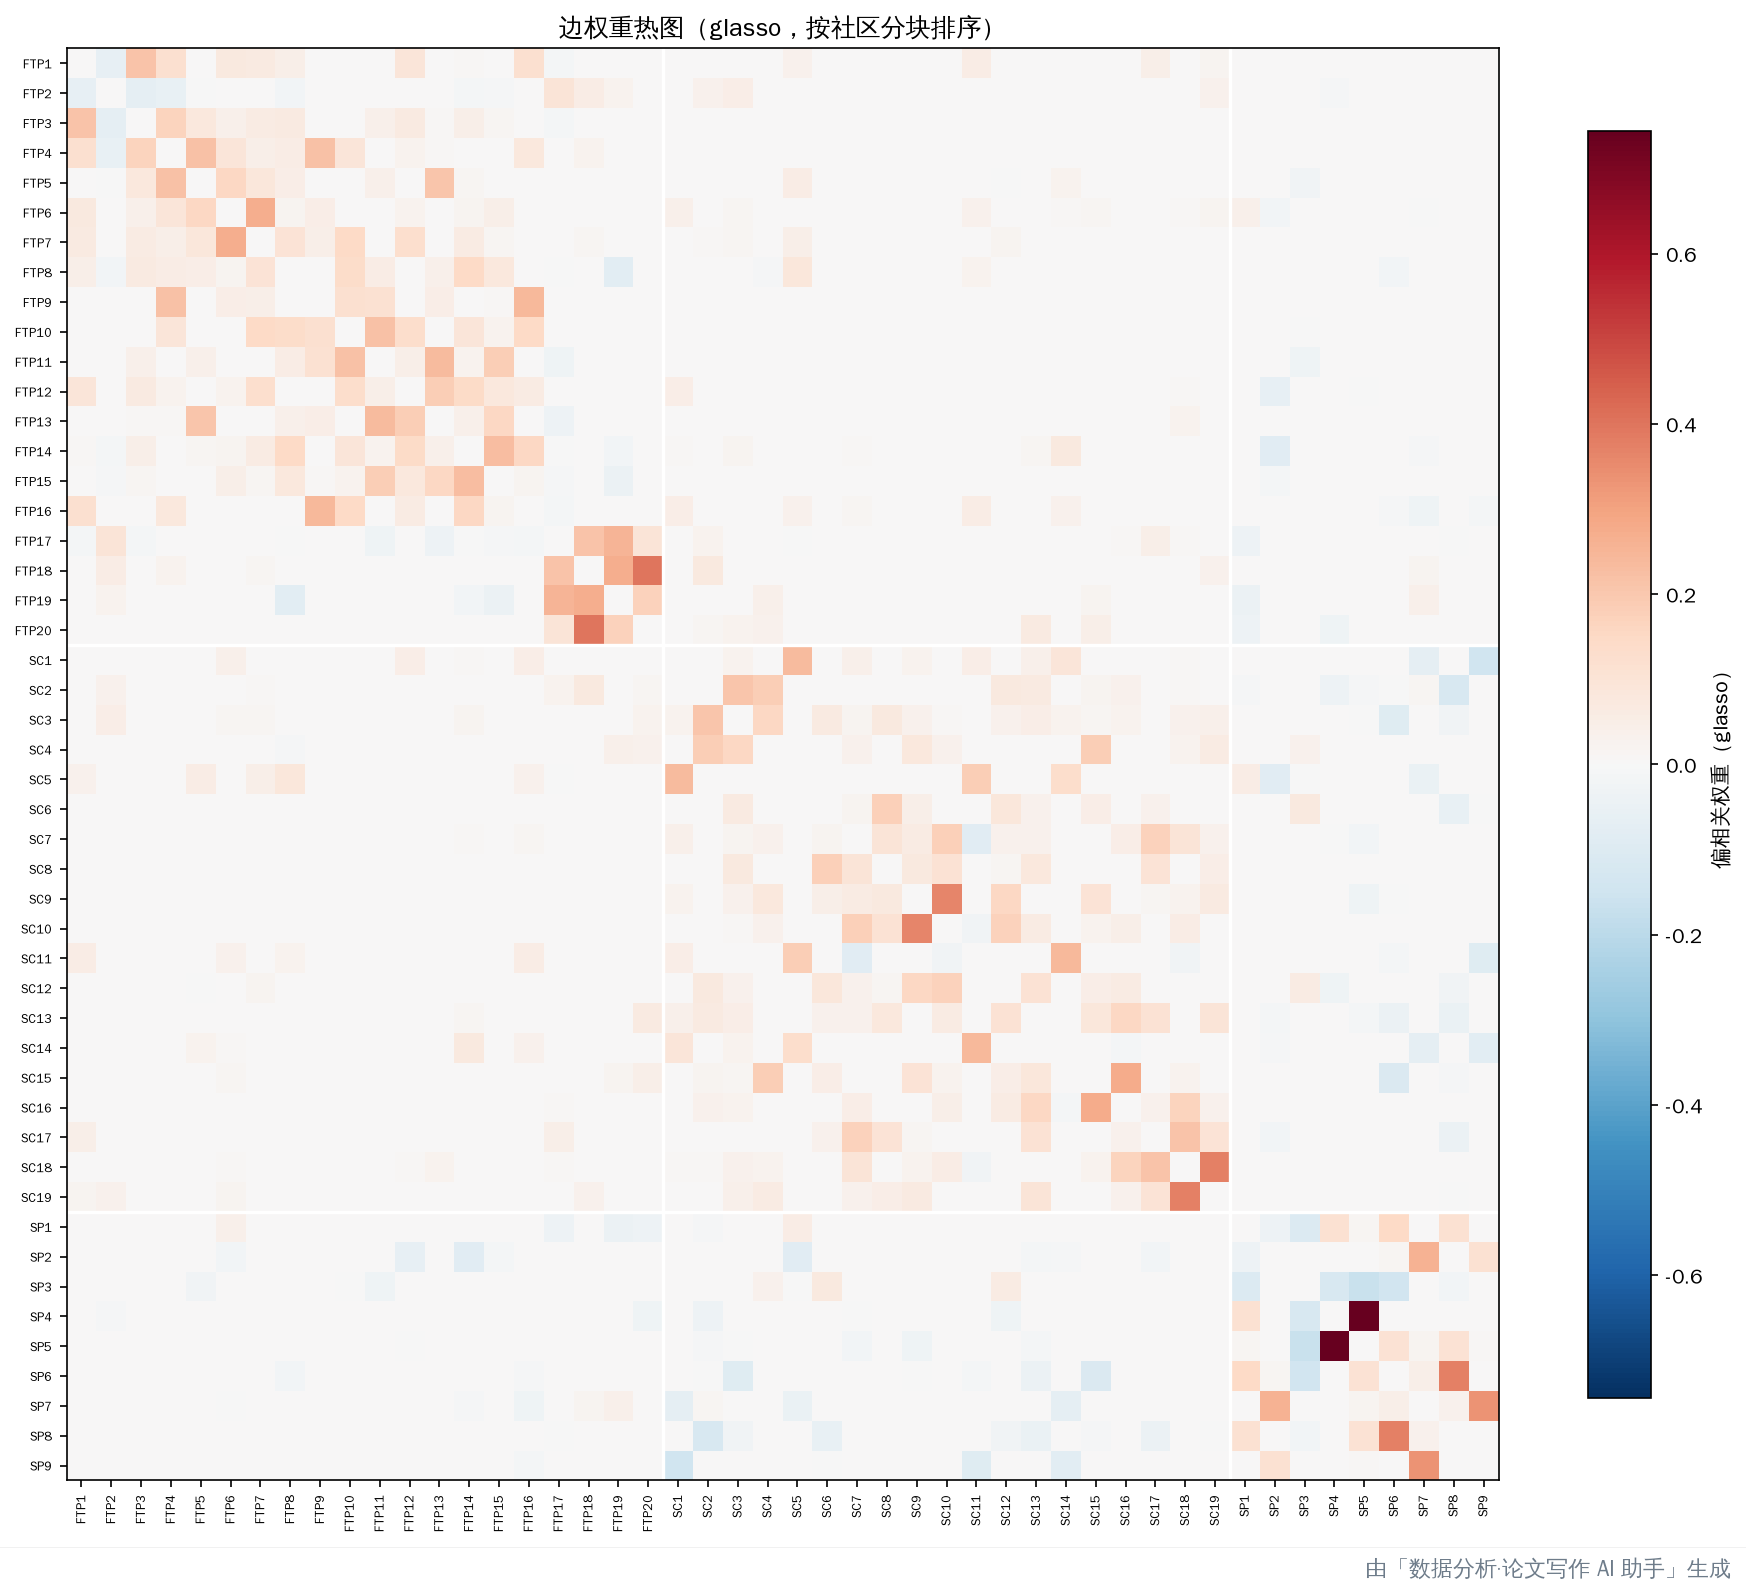
↑ 以上截图均由「数据分析·论文写作 AI 助手」对真实调查数据(护理专业学生样本,n=573)自动分析生成 · 带自己的数据去跑一遍 →
偏相关网络与稀疏化
原始偏相关矩阵通常满边(所有变量间均存在弱关联),直接看不出结构。需先稀疏化:用 graphical lasso + EBIC,调 γ 让弱边移除,核心连接才显现。γ 通常取 0.25–0.5;γ 太小(全连接)无结构、太大(无边)也无结构。
前提假设
- 变量类型合适:连续变量为宜;分类/有序需相应变体或转换。
- 样本与节点数匹配:节点多时偏相关估计不稳,需更大样本。
- 稀疏化参数选定:EBIC γ 影响最终结构,需报告并做敏感性分析。
何时用 · 何时不该用
- 用:想看变量系统的互联结构、找核心/桥节点、比较不同人群的网络结构。
- 别用:变量太少(两三个不如直接看相关);想推断因果(偏相关网络仍是关联非因果);样本相对节点数太小。
常见误区
高斯图模型:精度矩阵决定边
设 p 个节点变量服从多元正态 \(\mathbf{y}_i \sim N_p(\boldsymbol{\mu}, \boldsymbol{\Sigma})\)。精度矩阵是协方差矩阵之逆——
核心性质是多元正态的成对马尔可夫性质——
「控制其他所有变量后条件独立」⟺「精度矩阵该元素为 0」⟺「图中无边」。所以网络分析的边 = 非零偏相关,一次求逆 + 对角标准化就得到全部 \(p(p-1)/2\) 条边。
偏相关的数学:为什么是负元素
把变量分块 \(\mathbf{y}_1\)(要算的两个)与 \(\mathbf{y}_2\)(控制变量),条件分布的协方差是 Schur 补,而它恰好等于精度矩阵对应分块的逆——
对 2×2 分块求逆化简即得 \(\rho = -\theta_{jk}/\sqrt{\theta_{jj}\theta_{kk}}\)。三个等价视角:条件协方差的标准化、两残差的相关、标准化偏回归系数。原始相关为何会缩水——
偏相关剥掉的是第二项:当两变量的边际相关主要由共同原因传导时,偏相关明显缩水甚至归零——「原始相关 0.60 降到偏相关 0.50」的数学来源。
graphical lasso:L₁ 惩罚压出稀疏
非正则化路线(\(\hat{\boldsymbol{\Theta}} = \mathbf{S}^{-1}\) 再阈值化)有硬伤:p 接近 n 时 S 奇异病态、\(p(p-1)/2\) 次检验假阳性多、阈值是事后硬切。graphical lasso(Friedman, Hastie & Tibshirani, 2008)在估计时直接加 L₁ 惩罚——
\(\log\det\boldsymbol{\Theta} - \operatorname{tr}(\mathbf{S}\boldsymbol{\Theta})\) 是多元正态对数似然核(拟合项),\(\lambda\|\boldsymbol{\Theta}\|_{1,\text{off}}\) 是L₁ 惩罚(\(\|\cdot\|_{1,\text{off}} = \sum_{j\neq k}|\theta_{jk}|\))。L₁ 为何稀疏:菱形等高线与似然椭圆相切,切点常落在坐标轴上 → \(\theta_{jk} = 0\)。求解用块坐标下降,每列子问题的解是软阈值——
\((|s_{jk}| - \lambda)_+\) 表示「小于 λ 直接归零、大于 λ 收缩 λ」——弱边被精确压成 0,无需事后阈值。量表条目是序数数据,默认先做 Spearman 秩变换再进 glasso(Epskamp & Fried, 2018 推荐口径)。
| 维度 | 非正则化 + 阈值 | graphical lasso |
|---|---|---|
| 稀疏来源 | 事后阈值硬切 | 估计内禀稀疏(L₁) |
| 高维稳健 | 差(p→n 时病态) | 好(正则保正定) |
| 参数选择 | α(多重校正) | λ(EBIC 自动选) |
| 推荐 | 节点少、样本大、要 p 值 | 节点多、序数条目(默认) |
网络分析默认走 glasso + EBIC;非正则化保留供对比与需要 p 值的场景。
EBIC 选参:自动挑 λ
graphical lasso 沿 λ 路径拟合一串稀疏度,用扩展 BIC(Foygel & Drton, 2010)选最优——
第三项是 EBIC 特有的扩展项:γ 越大对「图越复杂」惩罚越重、网络越稀疏。γ = 0 时退化为 BIC;qgraph 默认 γ = 0.5,γ = 0.25 网络更密、γ = 0.75 更稀疏,建议报告敏感性分析。
稀疏定稿后的中心性指标——
稳定性:bootstrap 检验谁站得住
中心性排名对样本敏感,须 bootstrap 验证。核心指标是 CS-coefficient(case-dropping bootstrap)——
含义:随机丢弃 d 比例样本、重复估计,中心性排名与原排名相关 \(r_d\) 超过 0.7 的概率仍 ≥ 0.95 时,d 最大能到多少。CS < 0.25 不可接受、≥ 0.5 良好;介于 0.25–0.5 属「弱」,解读中心性需谨慎。另一条路线是 非参数 bootstrap(重抽样整样本)得边权与中心性的 CI。
社区检测用模块度——
\(m = \tfrac{1}{2}\sum w_{jk}\) 总边权、\(d_j\) 节点强度、\(\delta\) 指示同社区。Q 大 = 社区内密、社区间疏;Louvain 算法迭代最大化 Q。负权边按绝对值处理再检测。两组网络比较(NCT)用置换检验检验三个不变性:边权不变性(逐边)、全局强度不变性、网络结构不变性——置换的是个体归属,重估两组网络取差量分布。
方法选择决策树
不知道该用哪个方法?顺着研究问题定位 ——
为什么需要它
九个方法并非并列工具,各有各要回答的问题。新手最容易犯的错是"会用哪个就用哪个"——手里会 t 检验,就一律用 t 检验。决策树的用途是先问"我想回答什么",再找匹配的方法,而不是反过来。
怎么用
下图把九个方法按"它回答什么问题"排好。点任一方法块直接跳到对应概念页。方法之间有递进——上层方法常是下层的基础,跳阶容易产生概念断层。
补充说明
- 问题先于方法。先把研究问题用一句话说清("我想看 X 和 Y 什么关系" / "我想知道对谁效果更强"),再回来找方法。
- 方法递进。描述→相关→回归→调节/中介→SEM 是主干;信度贯穿始终,保证分数可用。
- 想看完整实操?选好方法只是第一步,后面还有跑真实数据、读输出表、查假设——见配套 实战流程。
- 不知道界面功能怎么用?上传、会话、权限授权等站内操作见 使用教程(三步上手 + 页内搜索)。